データベース設計は、業務で使うデータを洗い出して関連を整理し、同じ事実を1か所にだけ書く表の組み合わせに落とす作業です。
データ分析から始める
表を作る前に、まず業務の中身を調べます。図書館の貸出なら、だれが(会員)、どの本を(本)、いつ借りたか(貸出日)というデータ項目を洗い出し、 「会員が本を借りる」のような項目どうしの関連を整理します。 必要なデータ項目を洗い出し、項目間の関連を整理する作業をデータ分析といいます。
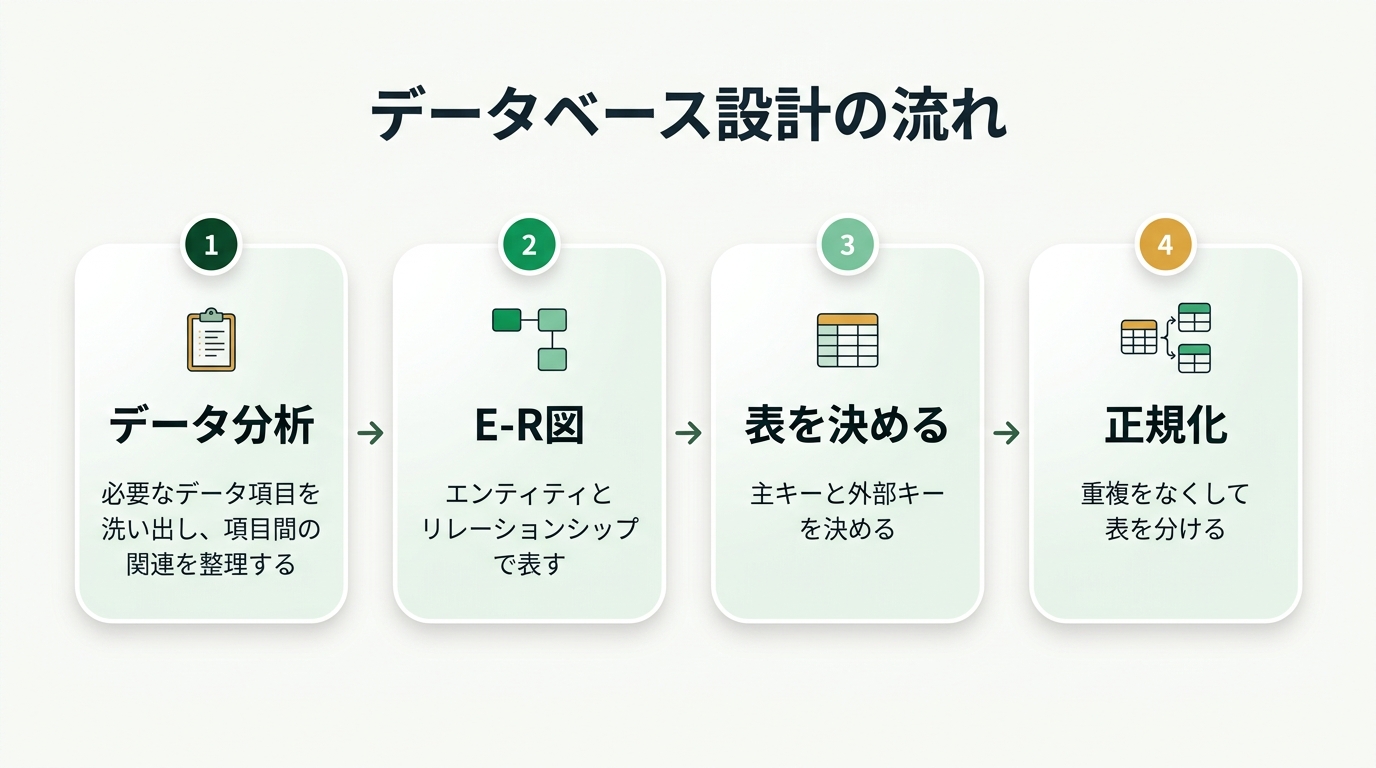
まず業務のデータを洗い出して関連を整理し、図にしてから表に落とします。
洗い出すときは、同じものの呼び方をそろえることも大事です。「会員番号」と「利用者ID」が同じ項目を指しているなら、名前をどちらか一方にそろえます。 データの中身も同じで、「(株)」と「株式会社」が混ざっていたり、入力の誤りが残っていたりすると、あとで正しく集計できません。 こうしたデータの値の表記の揺れや誤りを直してそろえる作業をデータクレンジングといいます。
データ分析と紛らわしい作業を1文ずつ。データウェアハウス(大量のデータをためた倉庫)から業務ごとに要る情報を取り出すのは、すでにできたデータの活用です。 表から条件に合う行だけを取り出すのは関係演算の選択で、できた表への操作です。 膨大なデータから統計的な手法などでビジネスに使える規則を探すのはデータマイニングです。 どれも表を作ったあとの話で、表を作る前に項目と関連を整理するデータ分析とは別物です。
E-R図 ── エンティティとリレーションシップ
整理した結果はE-R図に描きます。E はエンティティ(実体)、R はリレーションシップ(関連)です。
E-R図の部品
エンティティ … データとして管理したい「もの」や「できごと」。会員・本・貸出など。箱で描き、中に会員番号・会員名のような項目(属性)を並べる
リレーションシップ … エンティティどうしのつながり。「会員が本を借りる」など。箱と箱を結ぶ線で描く
1対多 … 線の両端に付ける数。1人の会員は何度も借りるが、1件の貸出の借り手は1人だけ。だから会員の側が「1」、貸出の側が「多」
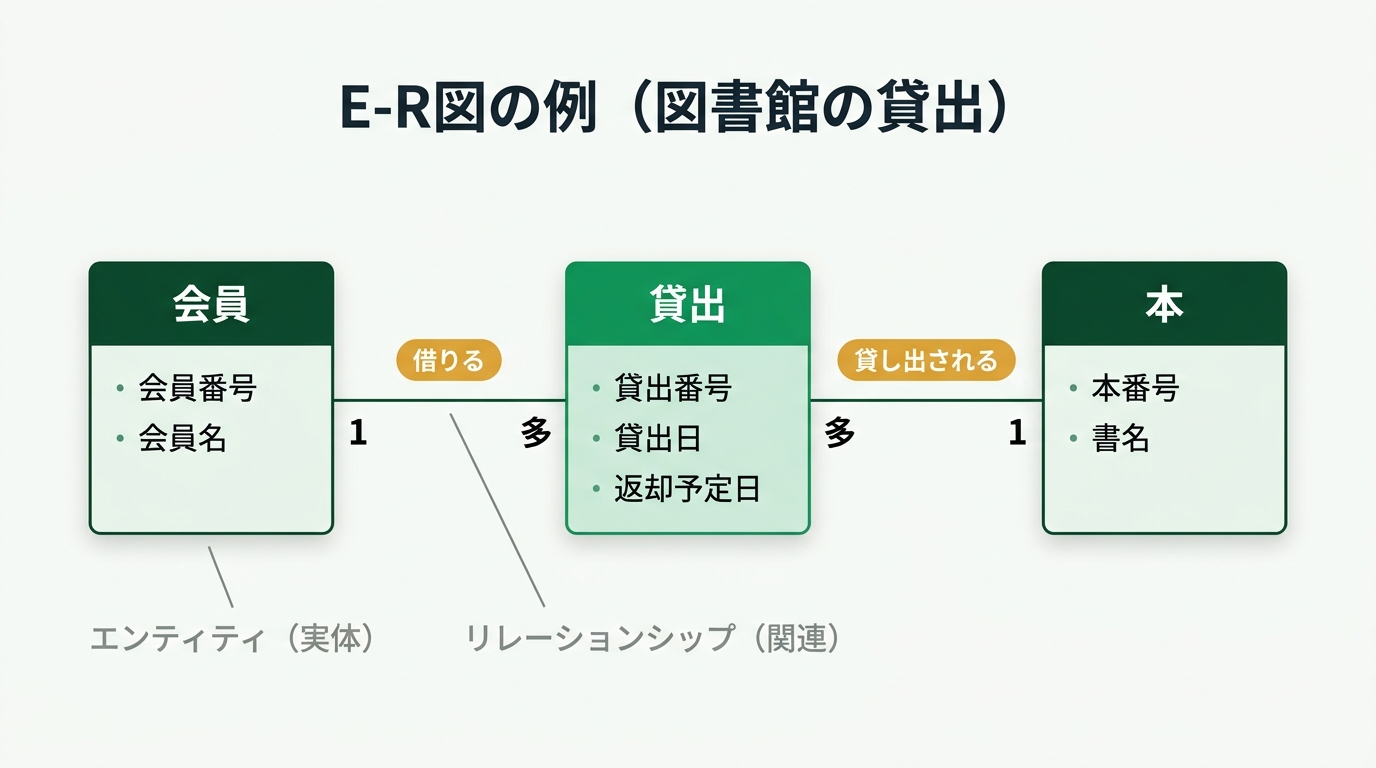
箱がエンティティ、線がリレーションシップ。線の両端の「1」と「多」が、相手といくつ対応するかを表します。
E-R図は、データを「もの(エンティティ)」と「つながり(リレーションシップ)」で表した設計図です。 この段階ではまだ表の形を決めていません。どの箱が1つの表になり、線がどの項目で結ばれるかを、次の主キーと外部キーで決めます。
主キーと外部キー
関係データベースでは、データを行と列からなる表(テーブル)に入れます。1行が1件のデータ(レコード)、1列が1つの項目(フィールド)です。 表の中の行を1つに特定するための項目を主キーといいます。会員の表なら会員番号です。 同じ名前の会員がいても、会員番号が違えば別の人だと分かります。
主キーの決まり
重複しない … ほかの行と同じ値になる項目は主キーにできない。会員名は同姓同名がありうるので主キーに向かない
空にしない … 主キーの値が空(未入力)の行は作れない。空では行を特定できない
複数の項目の組でもよい … 1つの項目では決まらないとき、2つ以上の項目を組にして主キーにできる
数値でなくてよい … 「M01」「B07」のような文字を含む番号でもよい。決め手は値が重ならないこと
組の主キーは、番号の振り方で決まります。学校で出席番号がクラスごとに1番から振られるなら、出席番号だけでは生徒が1人に決まりません。 1組の5番と2組の5番がいるからです。このときは「クラス」と「出席番号」の組を主キーにします。 反対に、1つの項目だけで行がただ1つに決まるなら、ほかの項目を足して組にはしません。主キーは、行を決めるのに必要な最小限の項目で作ります。 主キーは、その値(または値の組)で行がただ1つに決まる項目です。
表を分けると、表どうしを結ぶ項目が要ります。貸出の表に会員番号を入れておけば、そこから会員の表をたどって会員名が分かります。 このように、ほかの表の主キーを指すために持つ項目を外部キーといいます。
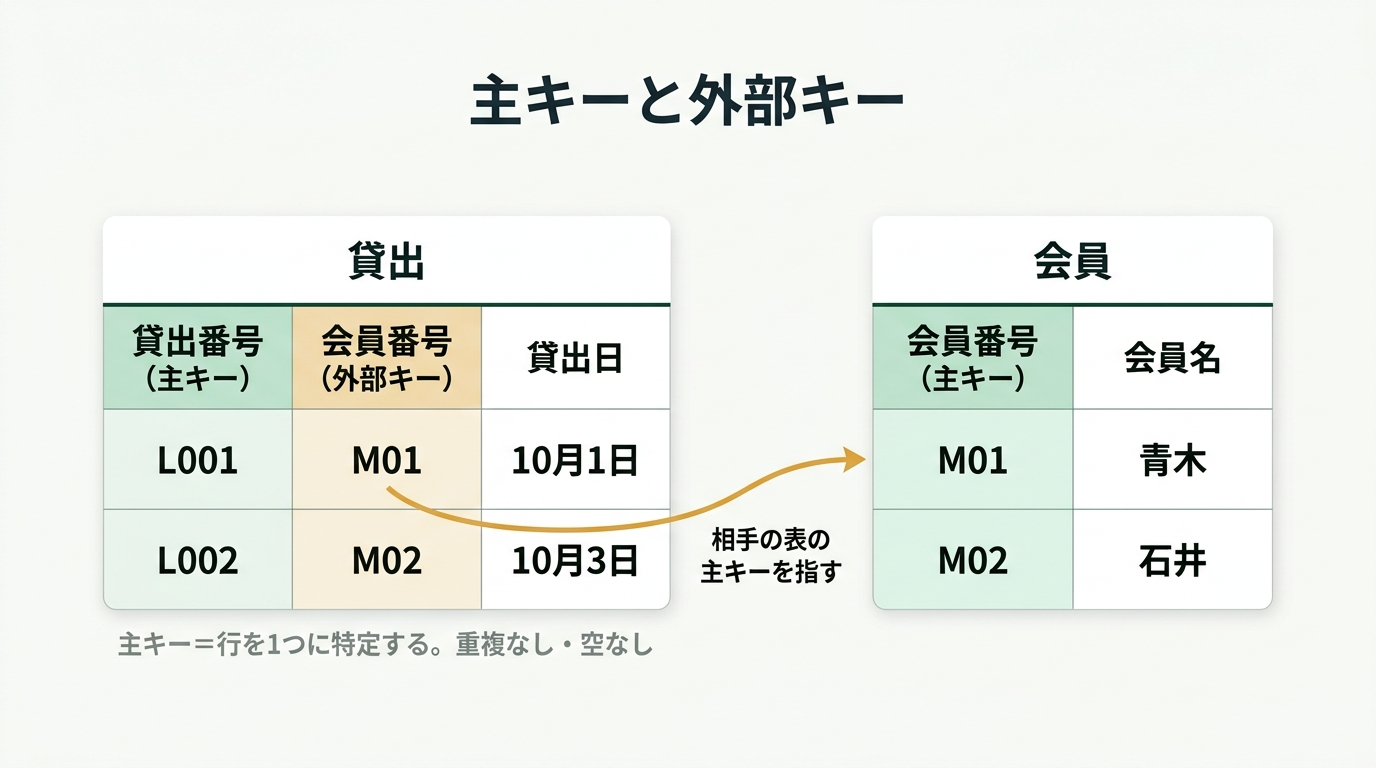
主キーは表の中で行を1つに決める項目、外部キーはほかの表の主キーを指す項目です。
主キーとインデックスも区別します。インデックスは、本の索引のように検索を速くするための仕組みです。 主キーは行を特定する決まり、インデックスは探す速さのための仕組みで、役割が違うので、主キーの列にインデックスを付けてもかまいません。
社員の資格取得を記録する表を作ります。列は「社員番号|資格コード|取得日」です。1人の社員は複数の資格を取り、1つの資格は複数の社員が取ります。 同じ社員が同じ資格を2回登録することはありません。主キーとして最も適切なものはどれですか。
× 1人の社員が複数の資格を取るので、同じ社員番号の行が何行もできます。社員番号だけでは行が1つに決まりません。
× 1つの資格を複数の社員が取るので、同じ資格コードの行が何行もできます。
○ 正解 社員番号と資格コードの組です。
同じ社員が同じ資格を2回登録しないので、2つの組なら行がただ1つに決まります。1つの項目で決まらないときは組を主キーにします。
× 同じ日に複数の社員が資格を取ることがあるので、取得日は重複します。
正規化 ── 同じ事実を1か所に
図書館の貸出を、1つの表「貸出記録」だけで管理していたとします。
分ける前:貸出記録
列 … 貸出番号(主キー)|貸出日|会員番号|会員名|本番号|書名
1行目 … L001|10月1日|M01|青木|B07|星の地図
2行目 … L002|10月3日|M02|石井|B07|星の地図
3行目 … L003|10月5日|M01|青木|B12|海辺の町
「M01 は青木さん」という事実が2行に、「B07 は星の地図」という事実も2行に重なっています。 青木さんが改姓して1行目だけ直し忘れると、同じ M01 なのに名前が2通りになり、どちらが正しいか分からなくなります。 データの一貫性が崩れた状態です。
そこで、表を分けて重複をなくします。これが正規化です。
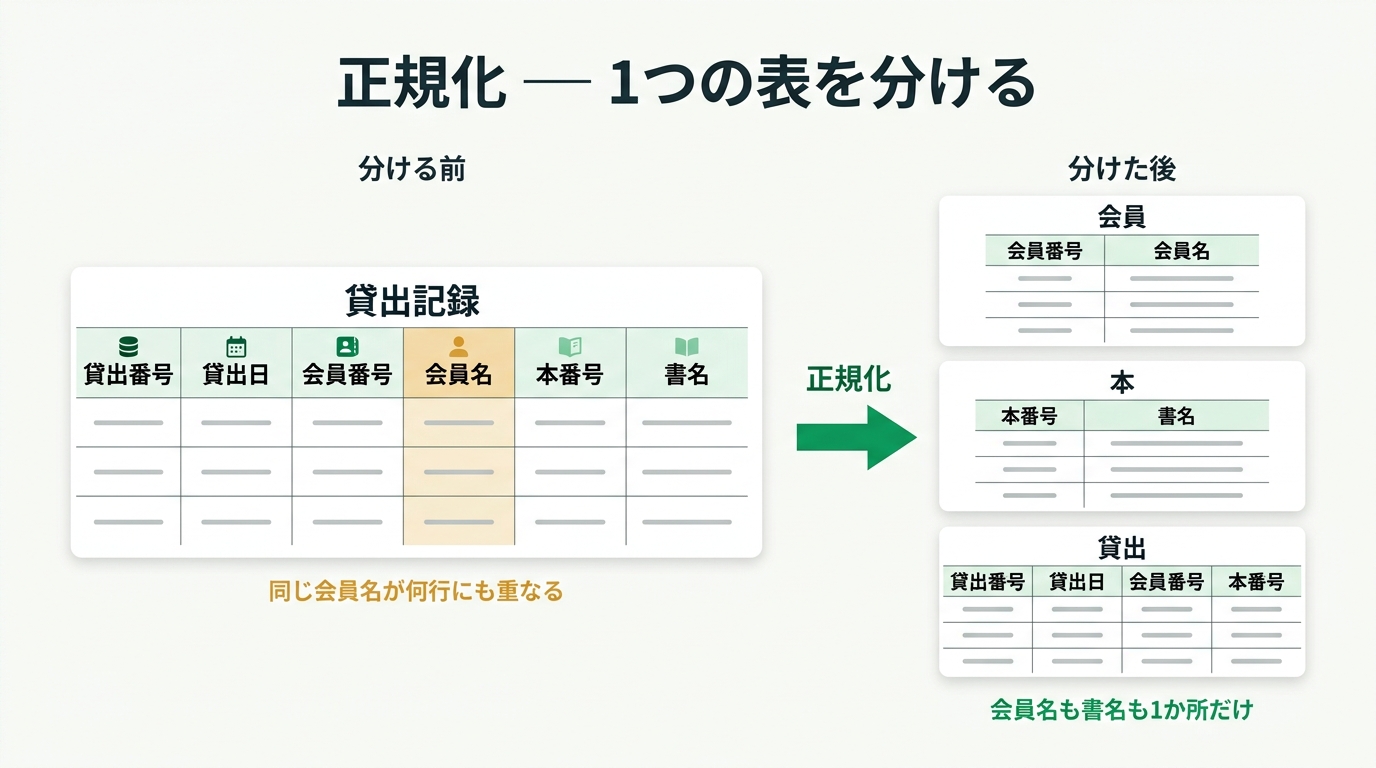
会員のことは会員の表に、本のことは本の表に1回だけ書き、貸出の表は番号で両方を指します。
分けた後:3つの表
会員 … 会員番号(主キー)|会員名 → M01|青木、M02|石井
本 … 本番号(主キー)|書名 → B07|星の地図、B12|海辺の町
貸出 … 貸出番号(主キー)|貸出日|会員番号(外部キー)|本番号(外部キー)
会員名は会員の表に1回だけ、書名は本の表に1回だけ書かれるので、改姓しても会員の表の1行を直せば済みます。 正規化の目的は、データの重複をなくして一貫性を保つことです。 正規化を進めると、1つの表が複数の表に分かれていきます。データを圧縮する技術ではありません。
どの項目をどの表に入れるかは、「その値は、何が決まれば1つに決まるか」で判断します。
行き先の決め方
会員名 … 会員番号が決まれば決まる → 会員の表へ
書名 … 本番号が決まれば決まる → 本の表へ
貸出日 … 同じ会員が同じ本を借りても日は毎回違う。貸出番号が決まって初めて決まる → 貸出の表へ
番号どうしのつながり … 貸出の表に会員番号と本番号を外部キーとして残す。残さないと、だれがどの本を借りたかが分からなくなる
問題文の「ただし書き」が行き先を決めます。たとえば「同じ商品でも値段が違えば商品番号も変える」とあれば、値段は商品番号で決まるので商品の表へ入れます。 一方、「何個買ったか」は商品ではなく注文ごとに変わるので、注文の表に残ります。 また、元の表の主キーが2つの項目の組だった場合(店舗ごとに1番から振る会員番号など)、その組が決まって初めて決まる項目(会員名など)を移した表では、主キーは組のまま持っていきます。 組の片方だけでは行が1つに決まらないからです。一方、店舗名のように店舗コードだけで決まる項目を移した表なら、主キーは店舗コードだけです。
レンタカー店が、予約を「予約番号|利用日|顧客番号|顧客名|車両番号|車種」の1つの表で管理しています。同じ顧客が何度も予約しています。 この表を正規化して「予約」「顧客」「車両」の3つの表に分けました。分けたことで得られる効果として最も適切なものはどれですか。
× 顧客名は顧客の表にだけ書かれます。予約と車両の表には顧客名がないので、直すのは1か所です。
○ 正解 顧客が名前を変えたとき、顧客の表の1行を直せば、その顧客のすべての予約に反映されるです。
予約の表は顧客番号(外部キー)で顧客の表を指すだけなので、名前は1か所にしかありません。直し忘れで名前が2通りになることもありません。
× 正規化はデータを圧縮する技術ではありません。表を分けた分、予約と顧客をつないで表示する手間はむしろ増えます。
× 顧客番号は外部キーとして予約の表に残します。消すと、だれの予約かが分からなくなります。
正規化とパフォーマンス
正規化で表を分けると、困ることも1つあります。画面に「貸出日・会員名・書名」を並べて出すには、貸出・会員・本の3つの表を番号で結合して組み立て直す必要があり、その分だけ処理が増えます。 正規化は一貫性のための設計で、速さは結合の手間とインデックスで調整します。 よく検索する項目にはインデックスを付けて、探す時間を短くします。
設計の順番は、まず正規化で「同じ事実は1か所」を守り、そのうえで速さが足りないところを調整する、が基本です。 なお、正規化には段階があり、FE などの上位の試験ではその手順まで問われますが、ITパスポートでは段階の名前や手順は問われません(現行シラバスに「正規化の詳細な内容は問わない」とあります)。 押さえるのはなぜ分けるのかと、分けた結果どの項目がどの表に入るかの2つです。
まとめ
この回で持ち帰ること
1. データ分析=必要なデータ項目を洗い出し、項目間の関連を整理する。表を作る前の作業。データクレンジングは表記の揺れや誤りを直してそろえること
2. E-R図=エンティティ(もの・できごと)を箱、リレーションシップ(つながり)を線で描く。線の両端に「1」「多」
3. 主キー=行をただ1つに特定する項目。重複しない・空にしない。複数の項目の組でもよく、数値でなくてもよい。インデックスと同じ列に付けてもよい
4. 外部キー=ほかの表の主キーを指す項目。表を分けても、つながりは外部キーで残す
5. 正規化=重複をなくして一貫性を保つ。進めると1つの表が複数の表に分かれる。行き先は「何が決まればその値が決まるか」で決める
6. 分けた表は結合して表示する。速さはインデックスなどで調整する
この節で解ける公開問題
令和4〜8年度の公開問題のうち、この節の知識で解ける問題は次の6問です。
教科書の一覧(現行の試験の順)教科書の一覧(新しい試験の順)過去問


Udemy の ITパスポート講座を、受講者数・★評価・口コミで比べたページです(広告を含みます)。
出典:IPA「ITパスポート試験 シラバス(案)Ver0.1」(2026年8月31日)、「ITパスポート試験 シラバス Ver6.5」、 「基本情報技術者試験 シラバス Ver9.2」(データベース設計)。 図と本文の表の例(図書館の貸出)は当サイトが説明のために作ったもので、練習問題も当サイトのオリジナルです。