生成AIは、文章・画像・プログラムなどを新しく作り出すAIです。たとえば「新商品の紹介文を3案書いて」と頼むと、まだどこにも無い紹介文を3つ返します。
生成AIと基盤モデル
総務省と経済産業省のAI事業者ガイドラインは、生成AIを「文章、画像、プログラム等を生成できるAIモデルにもとづくAIの総称」と定めています。 これまで広く使われてきたAIの多くは、迷惑メールかどうかを見分ける、明日の来店客数を見積もる、といった分類や予測をするものでした(18-1 機械学習)。 生成AIは、見分けたり見積もったりするのではなく、それまで無かった文章や画像を出力する点が違います。
生成AIの土台には、ふつう基盤モデルがあります。 基盤モデルは、広く大量のデータで学習し、そのうえでさまざまな用途に合わせて使えるモデルです。 最初の大がかりな学習を事前学習といい、ここでモデルの中の数値(パラメータ)が決まります。 中身はニューラルネットワークです(18-2 ディープラーニング)。
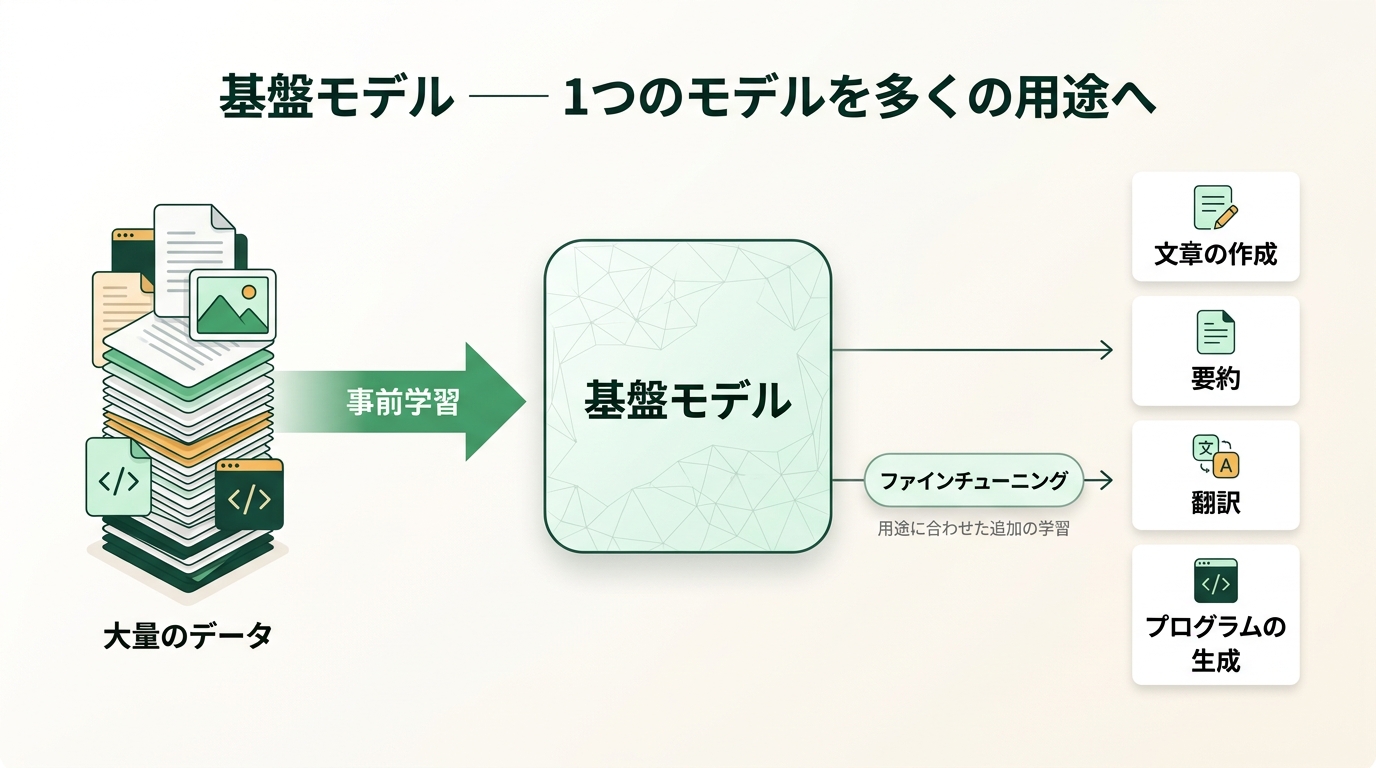
広いデータで事前学習した1つのモデルを、追加の学習などで多くの用途に合わせます。
事前学習を終えたモデルを、特定の用途に向けてもう一度学習させることをファインチューニングといいます。 たとえば、医療の文書を読ませて専門用語に強くする、といった使い方です。 ある仕事で学んだことを別の仕事に生かす考え方を転移学習といい、ファインチューニングもその1つです。 基盤モデルは、大がかりな事前学習で一度作っておき、ファインチューニングなどで用途ごとに合わせて使います。
RPA は、たとえば「毎朝、受注メールの金額を販売管理システムに打ち込む」といったパソコン作業を、人が組んだ手順のとおりにこなすツールです。RPA 自体はデータから学習せず、文章や画像を作ることもありません(18-2)。
画像を作る仕組み
画像の生成でよく知られる仕組みを2つ挙げておきます。敵対的生成ネットワーク(GAN)は、 本物そっくりの画像を作る生成器と、学習データの本物か生成器の作った偽物かを見分ける識別器の2つを、 競わせながら同時に学習させます。見破られないように作る側と、見破ろうとする側が互いに上達していきます。 拡散モデルは、ノイズだけの画像から出発して、ノイズを少しずつ取り除くことをくり返し、画像を作ります。
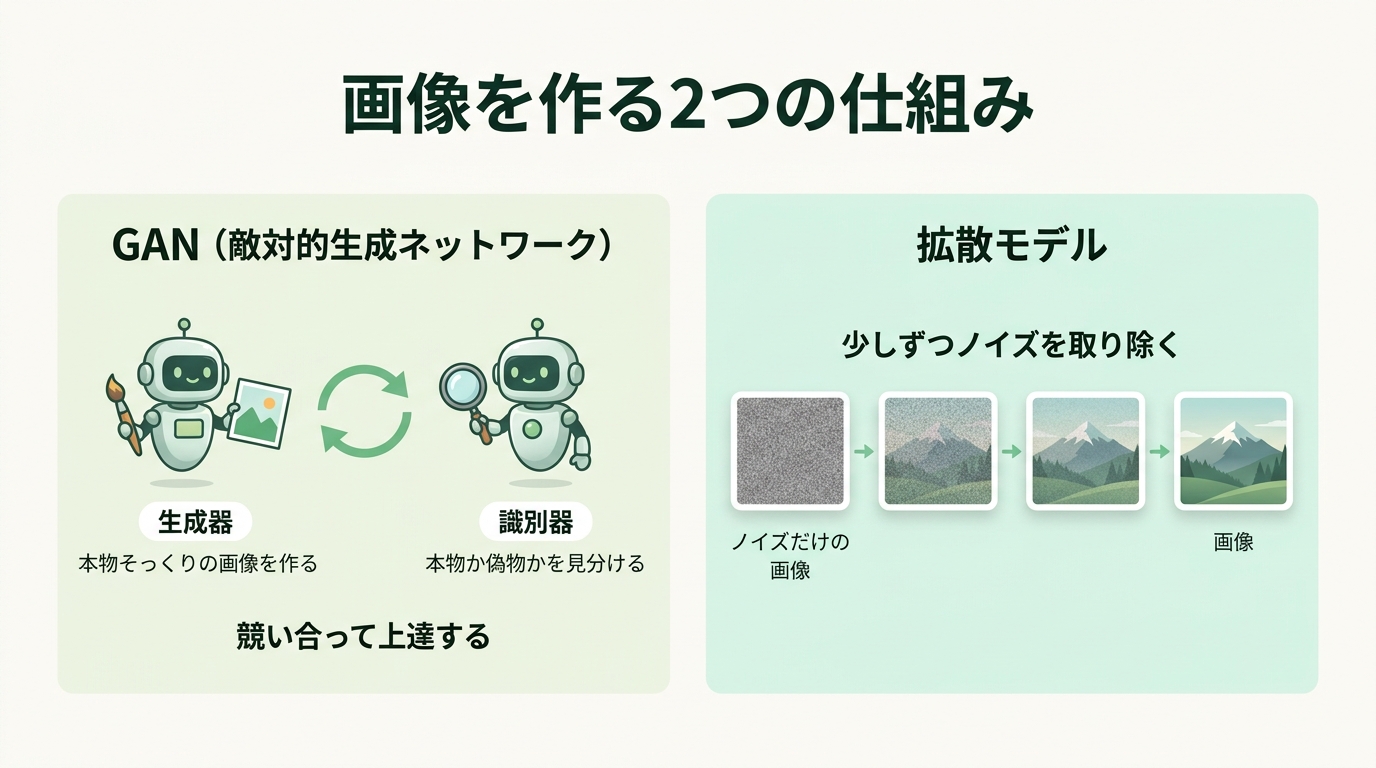
GAN は2つのモデルを競わせ、拡散モデルはノイズを少しずつ取り除いて画像を作ります。
本物と見分けにくい画像や音声を作れることは、なりすましに悪用されるおそれ(ディープフェイク)にもつながります(27-2 AI倫理)。
大規模言語モデル(LLM)とトークン
文章を作る生成AIの中心にあるのが大規模言語モデル(LLM)です。 とても多くのパラメータを持ち、大量の文章で事前学習した言語モデルで、AI事業者ガイドラインも基盤モデルの代表として挙げています。
LLM は文章を、文字の並びのままではなくトークンという単位に区切って扱います。 トークンは、1つの単語のこともあれば、単語の一部や1文字のこともあります。どう区切るかはモデルごとに決まっています。
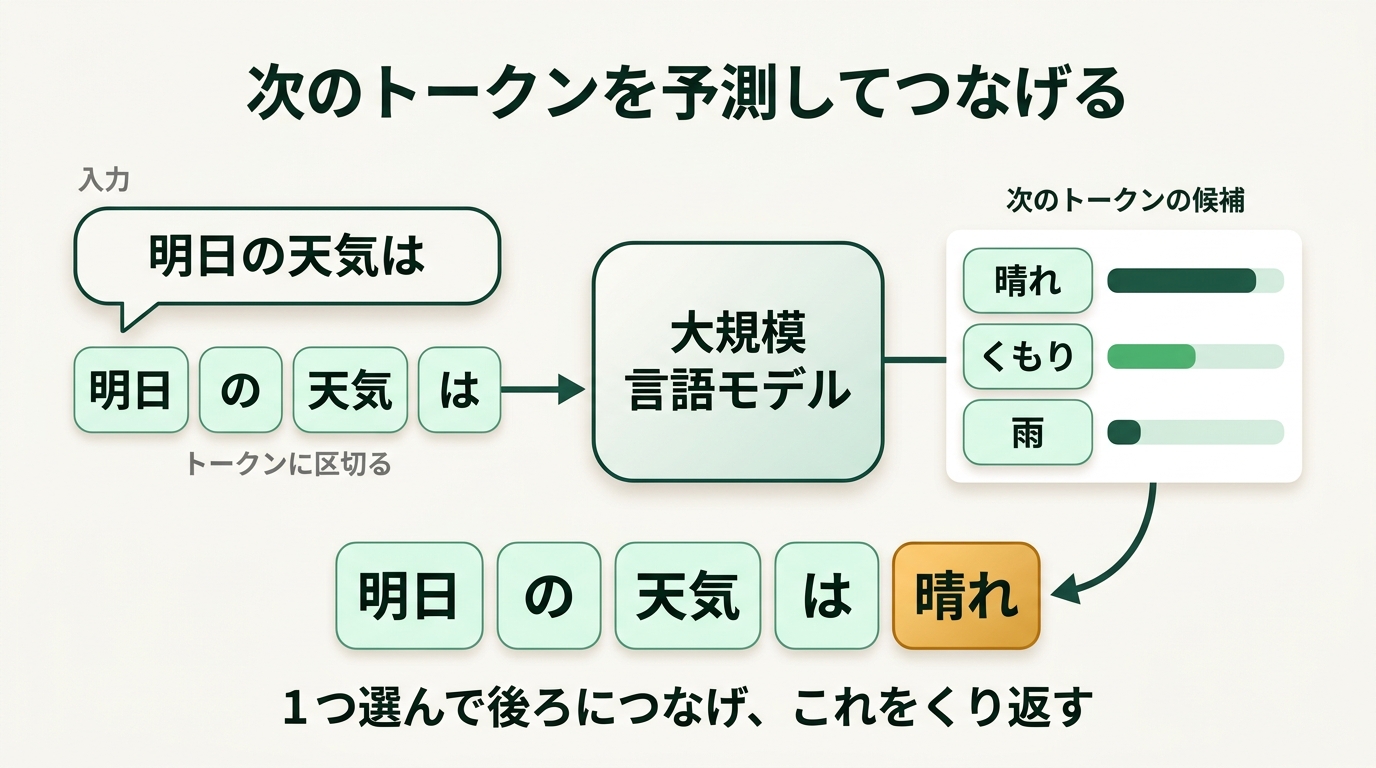
LLM は、次に来るトークンを予測して1つずつつなげることで文章を作ります(区切り方は一例です)。
LLM がしていることは、それまでのトークンの並びから、次に来るトークンを予測することです。 候補ごとの確率を計算して1つを選び、後ろにつなげます。つないだ結果を入力にして、また次の1つを選びます。 LLM は、次のトークンを予測して1つずつつなげることをくり返して、文章を作ります。 この仕組みから、次のことがわかります。
トークンの仕組みから言えること
確率で選ぶ … もっともらしい続きを選んでいるので、内容が事実かどうかは保証されない。同じ指示でも、毎回同じ答えになるとは限らない
長さに上限がある … 一度に扱えるトークンの数には、モデルごとに上限がある。長すぎる入力は、全部を読ませられないことがある
数える単位になる … 入力と出力の長さの上限や利用料金を、トークンの数で決めているサービスがある
もっともらしいのに事実と違う出力はハルシネーションと呼ばれます。くわしくは 27-2 で扱います。
コンテキスト内学習(In-Context Learning)
利用者がモデルに入力する指示や文章をプロンプトといいます。 LLM は、プロンプトの中にお手本の例をいくつか書いておくと、その例にならって、新しい入力に同じやり方で答えられることがあります。 これをコンテキスト内学習(In-Context Learning)といいます。
大事なのは、このときモデルのパラメータは1つも変わらないことです。 AI事業者ガイドラインも、コンテキスト内学習を「学習済パラメータを更新することなく」利用者の入力に応じて特定の仕事を学ばせる方法、と説明しています。 例を添える使い方は few-shot(少数の例)、例を添えずに指示だけで頼む使い方は zero-shot とも呼ばれます。
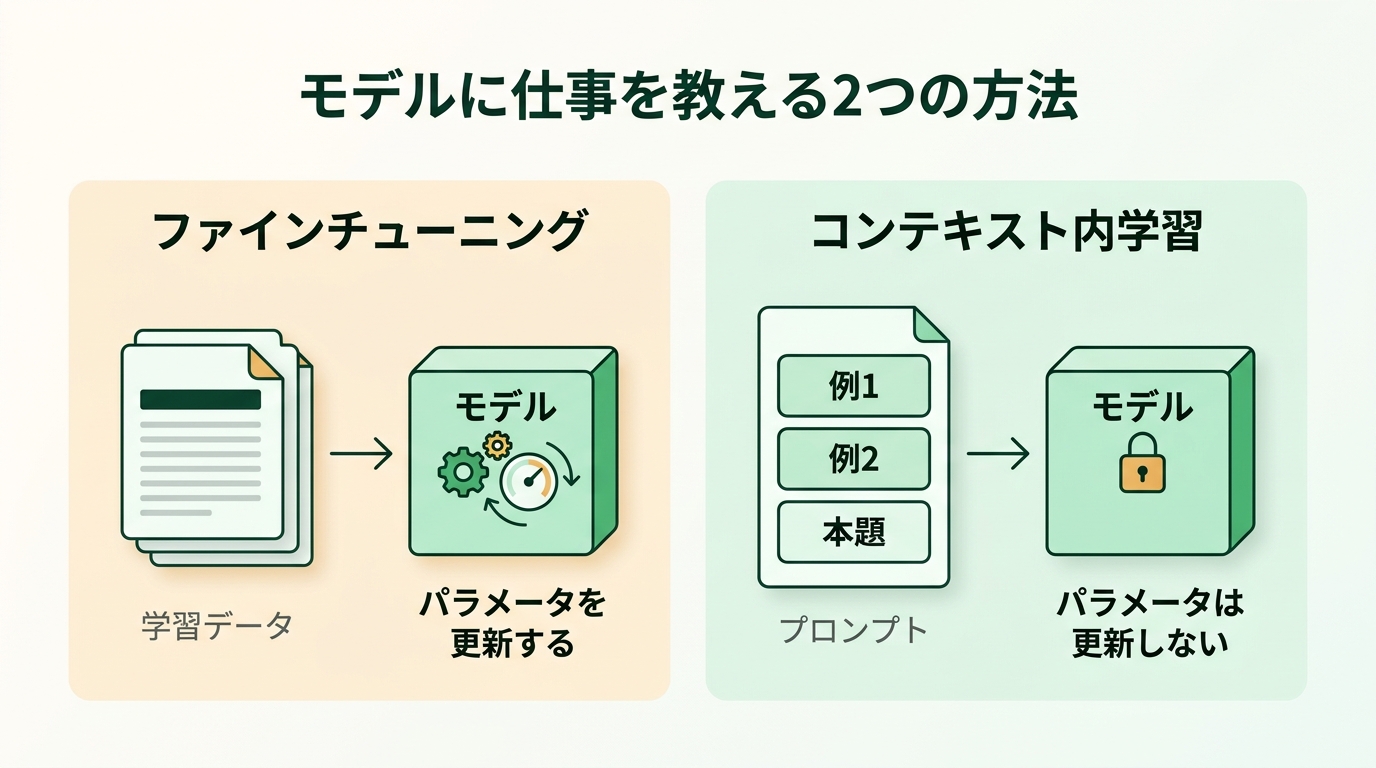
ファインチューニングはモデルを作り替え、コンテキスト内学習はプロンプトの中の例だけで仕事を伝えます。
モデルに仕事を教える2つの方法
ファインチューニング … 学習データを用意して追加で学習させる。パラメータが変わるので、その効き目はモデルに残る
コンテキスト内学習 … プロンプトに例を書くだけ。パラメータは変わらないので、例を書いたそのやりとりの中でしか効かない
コンテキスト内学習は、モデルを作り替えずに、プロンプトの中の例だけで仕事のやり方を伝える方法です。 例もプロンプトの一部なので、トークンの上限の中に収める必要があります。
ある会社が、問い合わせのメールを「請求」「配送」「その他」に分ける作業に LLM を使おうとしています。 担当者は、分け終わったメールを3通、それぞれの分類名といっしょにプロンプトに書き、その後ろに新しいメールを付けて送りました。 LLM は新しいメールを正しく分けました。モデルに追加の学習はさせていません。この方法にあたるのはどれですか。
× ファインチューニングは、学習データでモデルを追加で学習させ、パラメータを変える方法です。この場面ではモデルに追加の学習をさせていません。
× RAG は、答える前に外の文書を検索して、見つかった文章を入力に加える方法です。この場面の例は、担当者が自分でプロンプトに書いたもので、検索はしていません。
○ 正解 コンテキスト内学習です。
プロンプトの中にお手本の例を書き、パラメータを変えずに、その例にならって新しい入力に答えさせています。
× 事前学習は、モデルを作る最初の段階で、大量のデータからパラメータを決める学習です。できあがったモデルに例を見せることとは別です。
検索拡張生成(RAG)
LLM がパラメータとして身につけているのは、学習に使ったデータの範囲の知識です。学習のあとにできた情報や、社内の規程のように公開されていない情報は知りません。 知らないことを聞かれても、もっともらしい続きを作ってしまうことがあります。
そこで、答える前に外の情報を検索し、見つかった文章を入力に加えてから回答を作らせる方法があります。 これを検索拡張生成(RAG:Retrieval-Augmented Generation)といいます。 検索する先は、社内の文書やデータベース、Web などです。
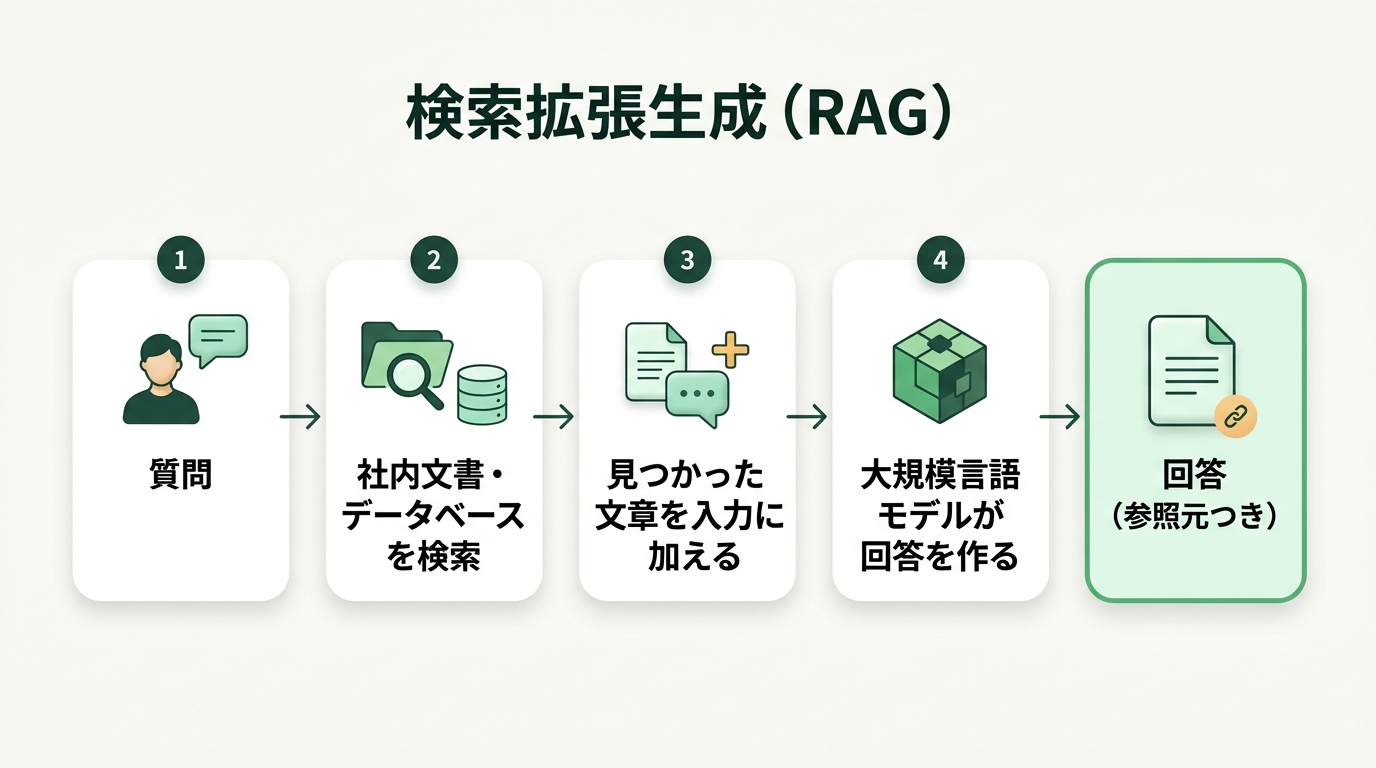
RAG は、答える前に外の文書を検索し、見つかった文章を入力に加えてから回答を作ります。
検索した文章を入力に加えること自体では、モデルのパラメータは変わりません。変わるのは、その回ごとにモデルへ渡す入力です。 RAG は、モデルを学習し直さずに、検索で見つけた最新の情報や社内の情報を答えに使う仕組みです。 検索する先の文書を新しくすれば、モデルを学習し直さなくても新しい内容で答えられます。
RAG で期待できることと、限界
期待できること … 学習のあとに更新された情報や社内の情報を使える。どの文書をもとに答えたかを示しやすい。AI事業者ガイドラインは、ハルシネーションを抑え、根拠を見えやすくする効果を期待できるとしている
限界 … 検索で見つかった文書がまちがっていたり古かったりすれば、答えもまちがう。同ガイドラインは、答えが似通いやすくなるので、独創性が欲しい仕事には向かない場合もあると注意している
ある会社が、社員からの質問に社内規程をもとに答えるチャットを LLM で作ります。規程は毎月のように改定されます。 改定後の規程にもとづいて答えさせる方法として、最も適切なものはどれですか。
× トークンを減らしても、モデルが改定後の規程を知らないことは変わりません。
○ 正解 最新の規程を検索して、その文章を入力に加えてから回答させる方法です。
RAG です。モデルを学習し直さなくても、規程の文書を差し替えるだけで、改定後の内容で答えられます。
× 社内規程は公開されていない情報なので、ふつう事前学習のデータには入っていません。改定後の内容も知りようがありません。
× 事前学習は大がかりで、毎月やり直すのは現実的ではありません。規程の文書を差し替えれば済む RAG のほうが合っています。
まとめ
この回で持ち帰ること
1. 生成AI=文章・画像・プログラムなどを新しく作るAI(分類や予測をするAIとは別)。土台は、広いデータで事前学習し多くの用途に合わせられる基盤モデル
2. ファインチューニング=事前学習済みのモデルを用途に合わせて追加で学習させる(パラメータが変わる)。転移学習の1つ
3. 画像の生成:GAN=生成器と識別器を競わせる。拡散モデル=ノイズを少しずつ取り除く
4. LLM は文章をトークンに区切り、次のトークンを予測してつなげる。確率で選ぶので正しさは保証されない。トークン数には上限がある
5. コンテキスト内学習=プロンプトに例を書いて仕事を伝える。パラメータは変わらない
6. RAG=答える前に外の文書を検索し、入力に加えてから回答を作る。最新・社内の情報を使え、根拠を示しやすい。モデルを学習し直さずに使える
この節で解ける公開問題
令和4〜8年度の公開問題のうち、この節の知識で解ける問題は次の2問です。
教科書の一覧(現行の試験の順)教科書の一覧(新しい試験の順)過去問


Udemy の ITパスポート講座を、受講者数・★評価・口コミで比べたページです(広告を含みます)。
出典:IPA「ITパスポート試験 シラバス(案)Ver0.1」(2026年8月31日)、「ITパスポート試験 シラバス Ver6.5」、 総務省・経済産業省「AI事業者ガイドライン(第1.2版)」本編(2026年3月31日)、 R. Bommasani ほか “On the Opportunities and Risks of Foundation Models”(2021)、T. Brown ほか “Language Models are Few-Shot Learners”(2020)、 P. Lewis ほか “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”(2020)、I. Goodfellow ほか “Generative Adversarial Nets”(2014)、 J. Ho ほか “Denoising Diffusion Probabilistic Models”(2020)。 練習問題は当サイトが説明のために作ったものです。