機械学習は、人がルールを書く代わりに、コンピュータがデータから規則を学び、新しいデータについて予測や判断をする技術です。
機械学習とは ── ルールを書く代わりにデータから学ぶ
迷惑メールを見分ける仕組みを作るとします。1つのやり方は、「件名に『当選』を含むなら迷惑メール」のような条件を人が考えて書き並べることです。 これをルールベースといいます。書いた条件どおりにしか動かないので、人が思いつかなかった形の迷惑メールは通ってしまいます。
機械学習では、条件を人が書きません。迷惑メールと通常のメールを大量に集めてコンピュータに与え、見分け方そのものをデータから見つけさせます。 条件を人が書いて動かすのはルールベースで、データから学んでいなければ機械学習ではありません。
2つのやり方は、推論の向きが逆です。ルールベースのように、すでにあるきまり(件名に「当選」を含むなら迷惑メール)を目の前の1通に当てはめて結論を出すのが演繹推論で、きまりと事実が正しければ結論も必ず正しくなります。 機械学習のように、観察した一つひとつの出来事(集めた大量のメール)をまとめて一般的なきまりを引き出すのが帰納推論です。 帰納で得たきまりは、まだ見ていないデータでくつがえることがあり、確実とはいえません(この回の最後に扱う過学習はその一例です)。
見分けの手がかりになる、データの性質を数などで表したものを特徴量といいます。メールなら、送信元、本文に出てくる語、本文中のリンクの数などです。 学習の結果できあがった判断の仕組みをモデル(学習済みモデル)と呼び、新しいデータをモデルに入れて答えを出させます。 従来の機械学習では、どの特徴量を使うかを人が考えて決めることが多く、大量のデータから特徴そのものを見つけ出すところまで任せるのが18-2 ディープラーニングです。
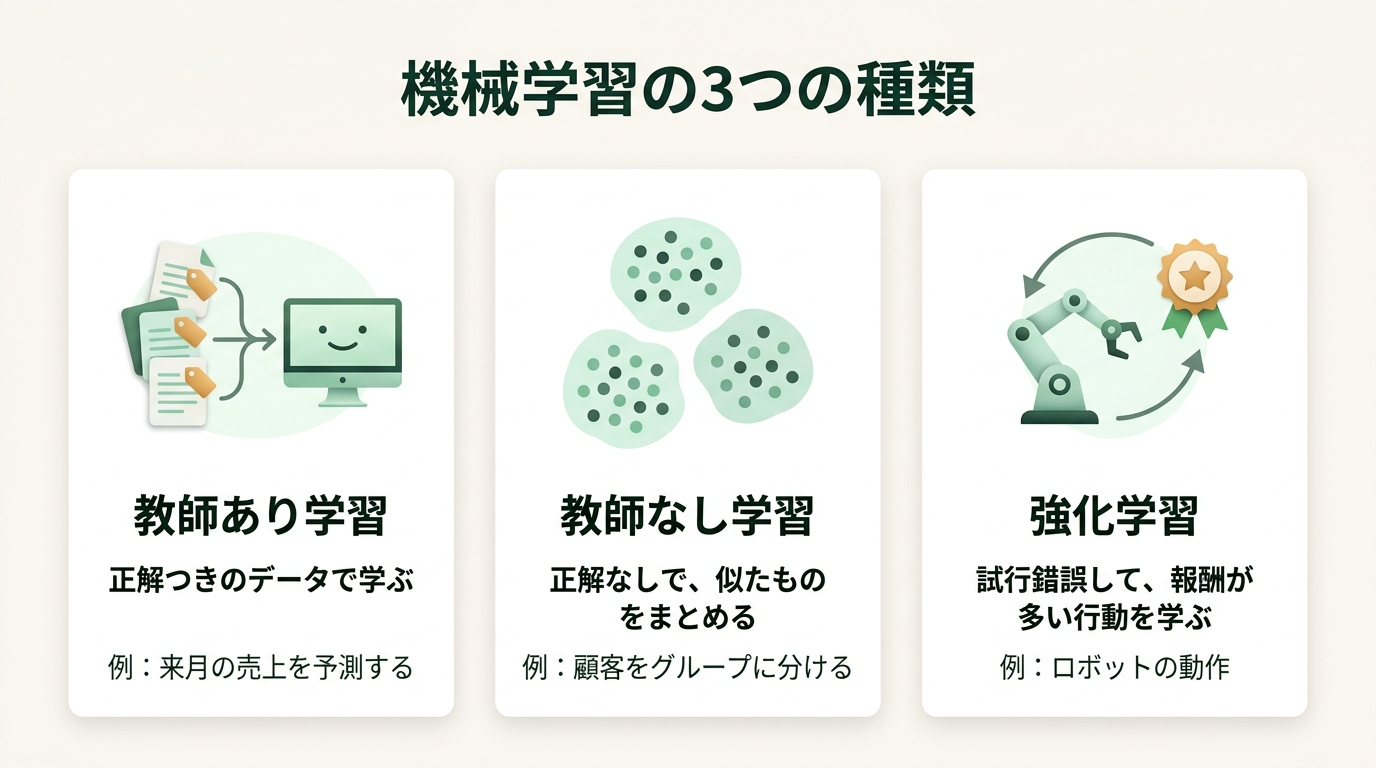
データに正解が付いているか、試行錯誤して報酬から学ぶかで、3つに分かれます。
機械学習の3つの種類
教師あり学習 … 正解を付けたデータで学ぶ。新しいデータの答えを当てる
教師なし学習 … 正解を付けないデータで学ぶ。似たものどうしのまとまりを見つける
強化学習 … 行動した結果の報酬から学ぶ。報酬が多くなる行動の選び方を身につける
教師あり学習 ── 正解つきのデータから学ぶ
教師あり学習は、入力と正解の組をたくさん与えて学ばせる方法です。「このメールは迷惑メール」「このメールは通常のメール」のように、1件ずつ正解が付いたデータを使います。 正解は先生(教師)が教えてくれる答えにあたるので、この名前があります。データに正解を付ける作業はアノテーションといい、9-2 データ分析とデータ利活用で扱います。
教師あり学習で身につけたモデルの使い方は、大きく2つです。
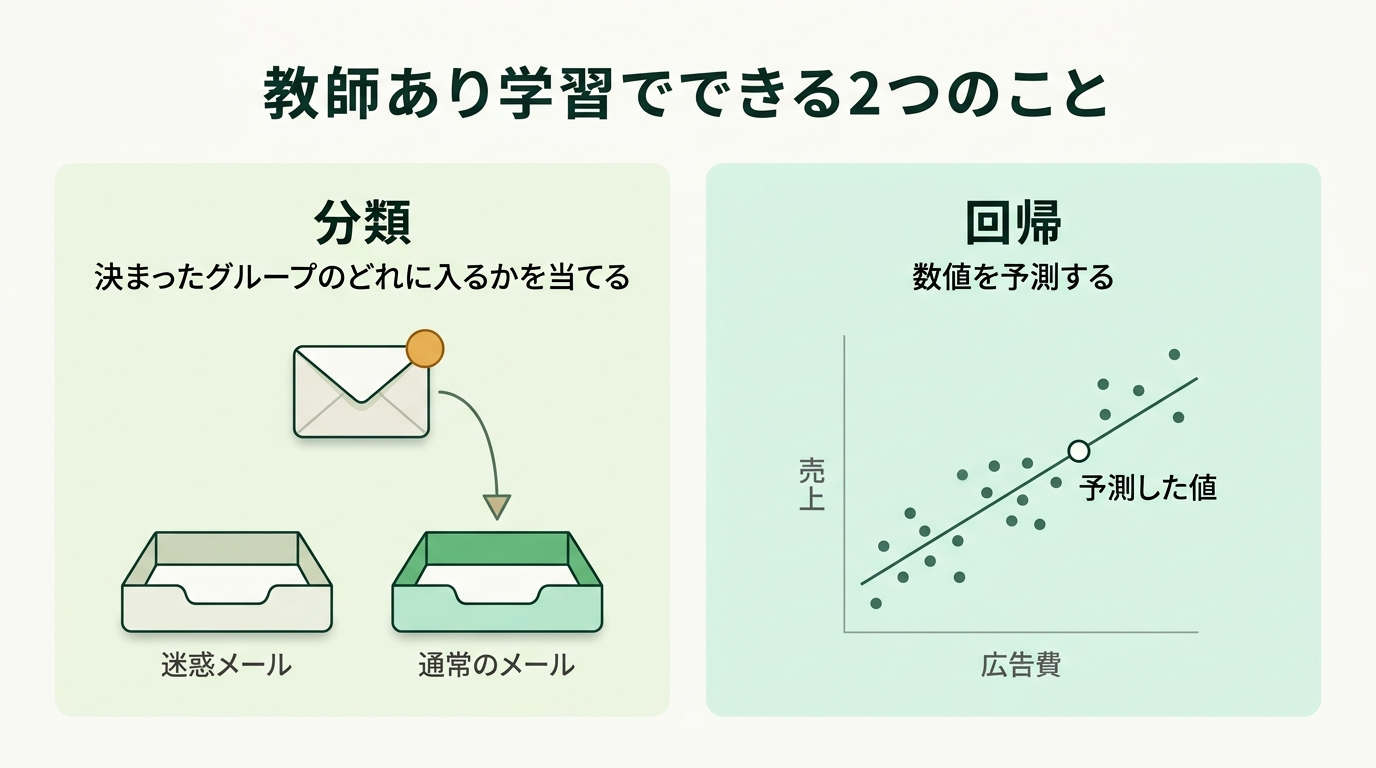
分類は決まったグループのどれかを当て、回帰は数値を予測します。
教師あり学習の2つの使い方
分類 … 入力が、前もって決めておいた選択肢(クラス)のどれに当たるかを答える。例:迷惑メールか通常のメールか、良品か不良品か、写真に写っているのが何か
回帰 … 入力の値が変わると結果の数量がどう変わるかを学んで、売上や需要のような数値を予測する。例:広告費から売上を予測する、過去の実績から来月の需要を予測する
答えが「どのグループか」なら分類、「いくつか」という数値なら回帰です。回帰の考え方は、統計の回帰分析(一方の値からもう一方の値を式で推定する)と同じ流れにあります。 業務では、売上予測、契約に至るかを見込む成約予測、顧客が離れていくかを見込む離反予測などに使われます。
教師あり学習かどうかは、入力と正解の組を集めて学ばせているかで見分けます。 たとえば、機械の動作音を録音したデータと、そのとき「故障していた/いなかった」という記録を組にして集めて学ばせ、新しい動作音から故障を推測するなら、教師あり学習です。 反対に、人があらかじめ書いた条件で判定するだけの説明(ルールベース)や、データの特徴が似たものを探す・まとめるだけで正解の組が出てこない説明は、教師あり学習の説明になっていません。
教師なし学習 ── 正解なしで似たものをまとめる
教師なし学習は、正解を付けないデータを与えて、データの中にある構造やまとまりを見つけさせる方法です。 代表的な手法がクラスタリングで、性質の似たデータどうしを集めて、いくつかのグループ(クラスタ)に分けます。
スーパーマーケットの会員の購買履歴をクラスタリングすると、「週末にまとめ買いする人たち」「毎日少しずつ買う人たち」のようなグループが見つかります。顧客をグループに分ける顧客セグメンテーションや、売れ方の似た店舗をまとめる店舗クラスタリングが、その使い方です。 ただし、見つかったグループに名前は付いていません。「週末にまとめ買い」といった意味は、結果を見た人が読み取って付けます。
分類とクラスタリングは、どちらも「グループに分ける」ので混同しやすい組です。 分類は、あらかじめ決めたグループに振り分けることを正解から学び、クラスタリングは、グループそのものを正解なしでデータから見つけます。
強化学習 ── 試行錯誤と報酬で行動を学ぶ
強化学習は、学習する側(エージェント)が、置かれた環境の中で行動し、その結果として受け取る報酬から学ぶ方法です。 よい結果になった行動には多くの報酬、まずい結果には少ない報酬(または罰)が返ってきます。これを何度もくり返し、報酬の合計が多くなる行動を選べるようになっていきます。
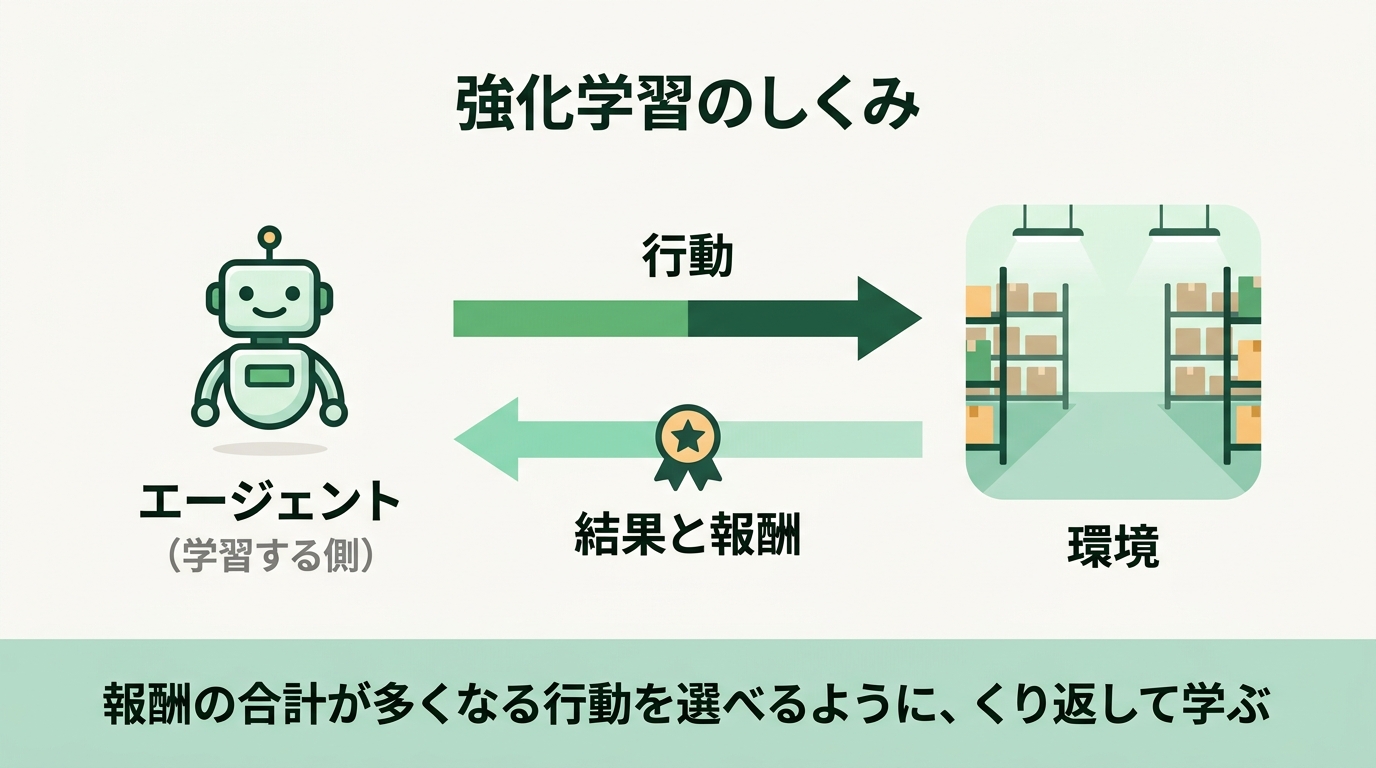
行動して、結果と報酬を受け取る。これをくり返して、報酬の合計が多くなる行動を学びます。
教師あり学習との違いは、1つ1つの行動に「正解」が与えられないことです。どう動くべきかは教わらず、動いてみた結果の良し悪しだけが報酬として返ってきます。 正解の組から学ぶのが教師あり学習、行動した結果の報酬から学ぶのが強化学習です。
ロボットのアームが物をつかむ動作を、試行錯誤の訓練をくり返して上手にしていく、という場面は強化学習の典型です。 ほかに、自動車の自動走行の制御、建物の揺れを抑える制御、配車ルートの最適化などに使われます。問題文に「訓練(試行)をくり返して上達する」「うまくいったら報酬を与える」とあれば、強化学習を指しています。
あるスーパーマーケットのチェーンが、AI を使う計画を4つ立てました。教師なし学習にあたるのはどれですか。
× 天気・曜日と、実際の売上(正解)の組から学んで数値を予測しているので、教師あり学習の回帰です。
× 写真と商品名(正解)の組から学び、決まった商品のどれかを当てているので、教師あり学習の分類です。
× 行動した結果の報酬から学んでいるので、強化学習です。
○ 正解 買い方の似た会員どうしをグループにまとめる計画です。
どのグループが正解かという答えは与えず、似たものどうしのまとまりをデータから見つけています。教師なし学習のクラスタリングです。
学習データと評価 ── 過学習を見抜く
モデルの出来は、まだ見ていないデータでどれだけ当たるかで決まります。そのため、集めたデータは役割ごとに分けて使います。
データの分け方
学習データ(訓練データ) … モデルに学ばせるためのデータ
検証データ … 学習の途中で、設定の良し悪しを確かめて調整するために、学習データとは別に取っておくデータ
テストデータ … 学習にも調整にも使っていないデータ。できあがったモデルの性能を最後に評価する
学習に使ったデータで評価すると、モデルは答えを知っているので、実力より高い成績が出てしまいます。 未知のデータに対しても正しく予測できる力を汎化性能といい、テストデータで測るのはこの力です。 評価には、テストデータのうち正しく当てた割合(正解率)などを使います。何を分母にとるかで別の指標になるので、問題文で割合の定義が示されたら、その定義どおりに計算します。
過学習は、モデルが学習データに合わせすぎて、学習データではよく当たるのに、未知のデータでは当たらなくなる状態です。 学習データにたまたま含まれていた細かなばらつきまで「規則」として覚えてしまうために起こります。
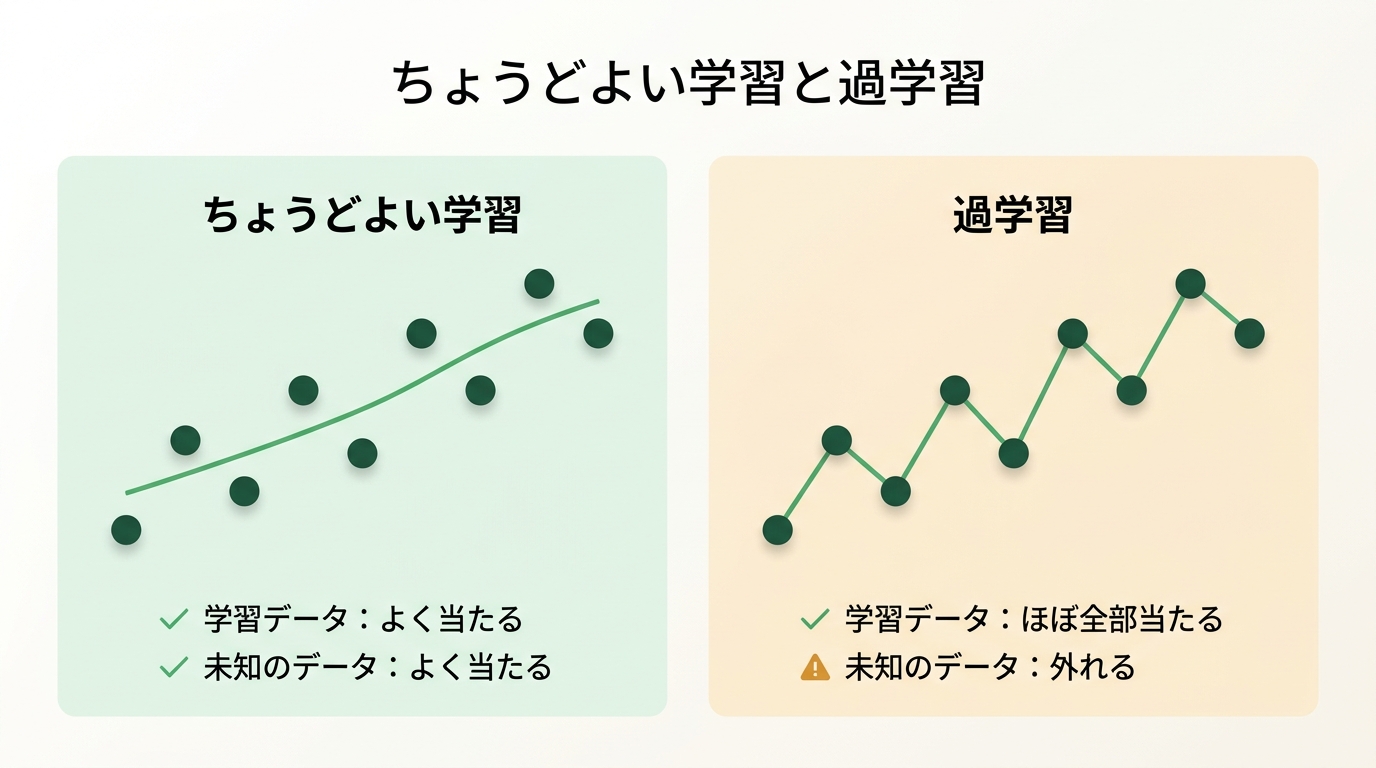
学習データの1点1点に合わせすぎると、まだ見ていないデータで外れるようになります。
学習データでの成績が高くても、テストデータでの成績が大きく下がるなら、過学習を疑います。 学習データが少ない、学習をくり返して学習データに合わせすぎる、といった条件で起こりやすくなります。 代表的な手当ては、学習データの数や種類を増やすこと、そして学習に使っていないデータで性能を確かめながら学習を進めることです。
製品の画像から不良品を見分けるモデルを作りました。学習に使った画像では99%正しく判定できましたが、学習に使っていない新しい画像では70%しか当たりませんでした。 この結果の読み方と次の手として、最も適切なものはどれですか。
× 本番で流れてくるのは、まだ見ていない画像です。そこで70%しか当たらないことが、このモデルの実力です。
○ 正解 過学習を疑い、データを増やして、学習に使っていない画像で評価し直すです。
学習データでは高く、未知のデータで大きく下がるのは、学習データに合わせすぎた過学習の典型です。
× 学習に使った画像はモデルが答えを知っているので、実力より高い成績が出ます。評価には学習に使っていないデータを使います。
× 学習データへの合わせすぎがさらに進み、新しい画像ではかえって当たらなくなるおそれがあります。
まとめ
この回で持ち帰ること
1. 機械学習は、データから規則を学ぶ技術。人が条件を書いて動かすだけならルールベースで、機械学習ではない。観察した出来事からきまりを引き出すのが帰納推論(くつがえることがある)、きまりを目の前の1件に当てはめるのが演繹推論
2. 教師あり学習=入力と正解の組から学ぶ。決まったグループのどれかを当てるのが分類、数値を予測するのが回帰
3. 教師なし学習=正解なしで、似たものをまとめる。代表はクラスタリング(顧客セグメンテーションなど)。グループの意味は人が読み取る
4. 強化学習=行動して受け取る報酬から、報酬の合計が多くなる行動を学ぶ。試行錯誤の訓練をくり返して上達するロボットなど
5. 学習データで学ばせ、学習に使っていないテストデータで評価する。学習データでは当たるのに未知のデータで当たらないのが過学習
この節で解ける公開問題
令和4〜8年度の公開問題のうち、この節の知識で解ける問題は次の2問です。
教科書の一覧(現行の試験の順)教科書の一覧(新しい試験の順)過去問


Udemy の ITパスポート講座を、受講者数・★評価・口コミで比べたページです(広告を含みます)。
出典:IPA「ITパスポート試験 シラバス(案)Ver0.1」(2026年8月31日)、「ITパスポート試験 シラバス Ver6.5」、 「基本情報技術者試験 シラバス Ver9.2」「基本情報技術者試験 シラバス(案)Ver0.1」。 練習問題と例は当サイトが説明のために作ったものです。