データを業務に生かすには、何のデータかを見分け、分析できる形に整え、統計の道具で読み取る、の3段が要ります。
データの種類 ── 何を、どこから集めたか
データは「だれが何のために集めたか」と「どんな形か」で分けます。
データの分け方
1次データ … 自分の目的のために、自分で集めたデータ。アンケートや実験の結果など
2次データ … ほかの人や機関が別の目的で集めたものを利用するデータ。公的な統計など
構造化データ … 行と列の表の形に整っているデータ。売上表、データベースの表など
非構造化データ … 決まった表の形を持たないデータ。文章、画像、音声、動画など
出どころでは、閲覧や購買の履歴などの人の行動ログデータ、機械やセンサーが記録する機械の稼働ログデータ、SNS の投稿などのソーシャルメディアデータがあります。 国・自治体・事業者が持つデータのうち、営利・非営利を問わず二次利用できるルールで、機械判読に適した(コンピュータで自動的に加工・編集できる)形にして、無償で利用できるように公開したものがオープンデータ、購買履歴や位置情報など個人に関するデータがパーソナルデータです。
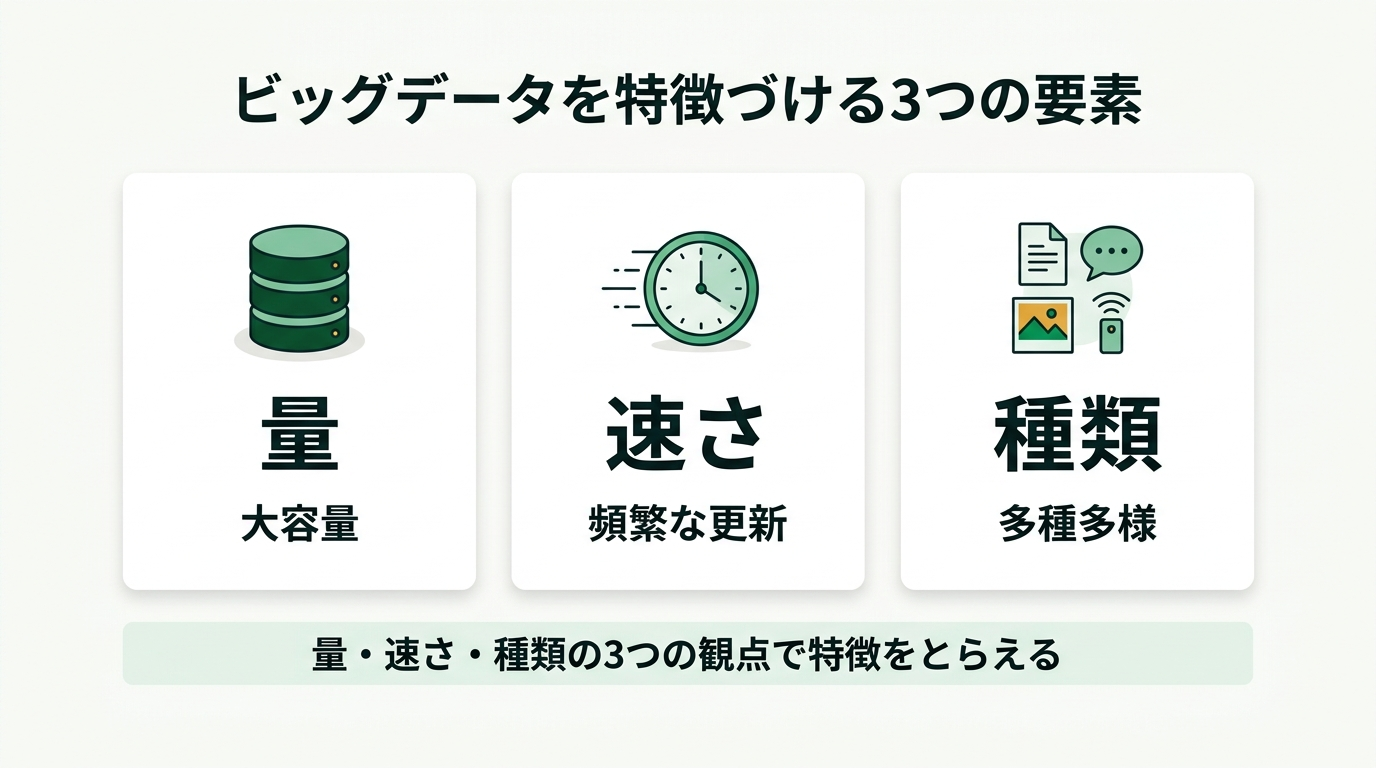
量・速さ・種類の3つで、ビッグデータを特徴づけます。
ビッグデータは、量(大容量)・速さ(頻繁な更新)・種類(多種多様)の3つの要素で特徴づけるのが代表的な考え方です。 英語の Volume・Velocity・Variety の頭文字から3V と呼ばれます。
分析の前にデータを整える
複数の表を顧客番号などの共通の項目で結びつけるのがデータ結合です。同じ顧客が別人として登録されていると、正しく集計できません。
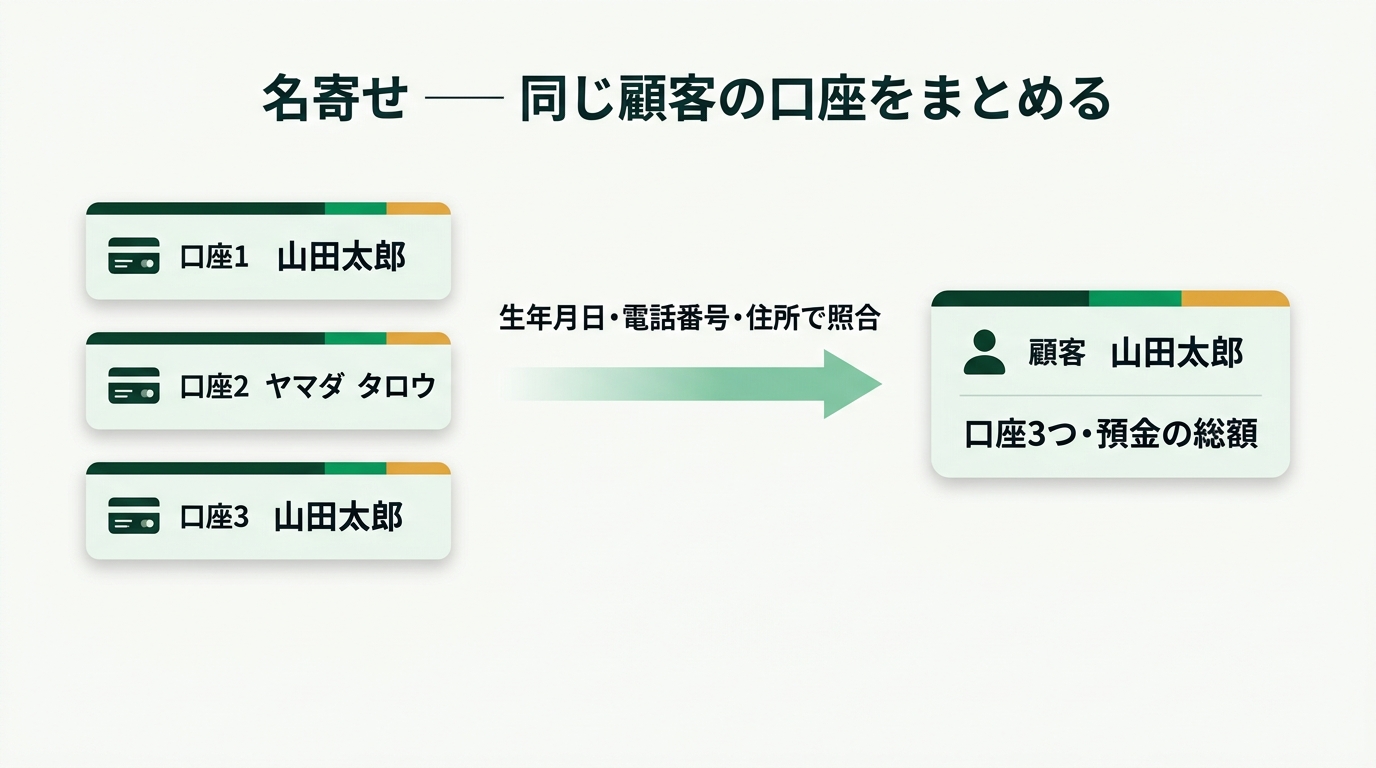
名前の書き方が違っても、ほかの手掛かりで同じ顧客と分かれば1人分にまとめます。
同じ人や同じ会社のデータを、名前・生年月日・電話番号・住所などを手掛かりに1つにまとめる作業を、名寄せといいます。 銀行が1人の顧客の複数の口座をまとめ、預金の総額をつかむのが代表例です。 アカウントアグリゲーションは、複数の金融機関の口座情報を利用者が1つのアプリなどでまとめて見られるサービス、 垂直統合は製造から販売までの異なる段階を1つの企業グループにまとめる経営の手法、 キーマッピングはキーボードのキーなどに機能を割り当てる設定で、どれも名寄せではありません。
そのほかの下ごしらえ
外れ値の処理 … ほかの値から大きく離れた値。誤りとは限らず実際に起きた値のこともあるので、原因を確かめ、目的に合わせて扱いを決める
異常値の処理 … 入力ミスや機器の故障など、誤りと分かっている値(身長 1,700cm など)。除くか、正しい値に直す
欠損値の処理 … 値が入っていない項目。その行を除くか、平均値などで補う
アノテーション … データに正解などの情報(ラベル)を付ける作業。教師あり学習の正解データになる
季節調整 … 毎年決まった季節に起きる増減を取り除き、本来の動きを見えるようにする
移動平均 … 一定期間の平均を1期ずつずらして求め、細かな上下をならす
販売数が 1月12・2月18・3月15・4月21 のときの3か月移動平均です。
3か月の移動平均=(直近3か月の合計)÷3
  3月の値:(12+18+15)÷3 = 45÷3 = 15
  4月の値:(18+15+21)÷3 = 54÷3 = 18
誤り・重複・表記の揺れを直すデータクレンジング、決まった方式で別の形式に変換するエンコード、条件に合うものだけを選ぶフィルタリングは、正解を付ける作業ではありません。 大量のデータから規則性を見つけ出すのがデータマイニング、文章から単語の出方やつながりを分析するのがテキストマイニングです。
AI の学習データでは、整え方が AI の偏り(バイアス)と品質に響きます。確かめることは、 学習の目的に合ったデータか、データの入手元と作られた経緯(来歴)、アノテーションを学習の目的に合わせて付けているかです。 また、人が見ても何が写っているか決められない画像は、正しいラベルを付けられないので、学習用のデータから除きます。
ある店のかき氷の月別売上は、毎年7〜8月に大きく増えます。今年4月に始めた値下げの効果を、月ごとの売上の動きから確かめたいとき、最初にする処理として最も適切なのはどれですか。
× 名寄せです。夏に売上が増える動きは残ったままです。
× 夏の増加は誤りではなく実際の売上です。消すと夏の効果も見られなくなります。
○ 正解 季節調整です。
毎年の夏の増加分を取り除けば、値下げのあとに動きが変わったかを比べられます。
× アノテーションです。効果は分析で確かめるもので、先に人が正解を付けるものではありません。
代表値・ばらつき・尺度
データ全体を1つの数で表すのが代表値です。平均値は合計を個数で割った値、中央値は小さい順に並べたときの真ん中の値、最頻値はいちばん多く現れる値です。 7人の1か月の書籍代(円)が 10・30・30・40・50・60・900 だったとします。
平均値=合計÷個数
  (10+30+30+40+50+60+900)÷7 = 1,120÷7 = 160
中央値=小さい順に並べた真ん中(7個なら4番目)
  10, 30, 30, 40, 50, 60, 900 の4番目 = 40
最頻値=いちばん多く現れる値
  30 が2回 = 30
6人は60円以下なのに平均値は160円です。平均値は1つの飛び抜けた値に引っ張られますが、中央値はほとんど動きません。 個数が偶数のときの中央値は、真ん中の2つの平均です(20・30・50・100 なら(30+50)÷2=40)。
4, 4, 6, 6 と 2, 2, 8, 8 は、どちらも平均値は5ですが、値の散らばり方(ばらつき)が違います。 この違いを1つの数で表すのが分散と標準偏差です。各値と平均値との差を2乗して平均したものが分散、その平方根が標準偏差です。
標準偏差=(各値-平均値)の2乗の平均の平方根
  4, 4, 6, 6(平均5):差は -1, -1, 1, 1 → 2乗の平均 1 → 標準偏差 1
  2, 2, 8, 8(平均5):差は -3, -3, 3, 3 → 2乗の平均 9 → 標準偏差 3
標準偏差が大きいほど、値が平均値から広く散らばっています。ばらつきが違うテストの点数を比べるために、得点が平均点より標準偏差いくつ分上か(下か)を、平均を50、標準偏差1つ分を10として表したのが偏差値です。
偏差値=50+10×(得点-平均点)÷標準偏差
  平均60点・標準偏差5点のテストで70点:50+10×10÷5 = 70
  平均60点・標準偏差10点のテストで70点:50+10×10÷10 = 60
同じ70点でも、ばらつきの小さいテストのほうが偏差値は高くなります。平均点も標準偏差も違うテストどうしの成績は、(得点-平均点)÷標準偏差の大きさで比べます。
どんな計算に意味があるかは、データの尺度で決まります。
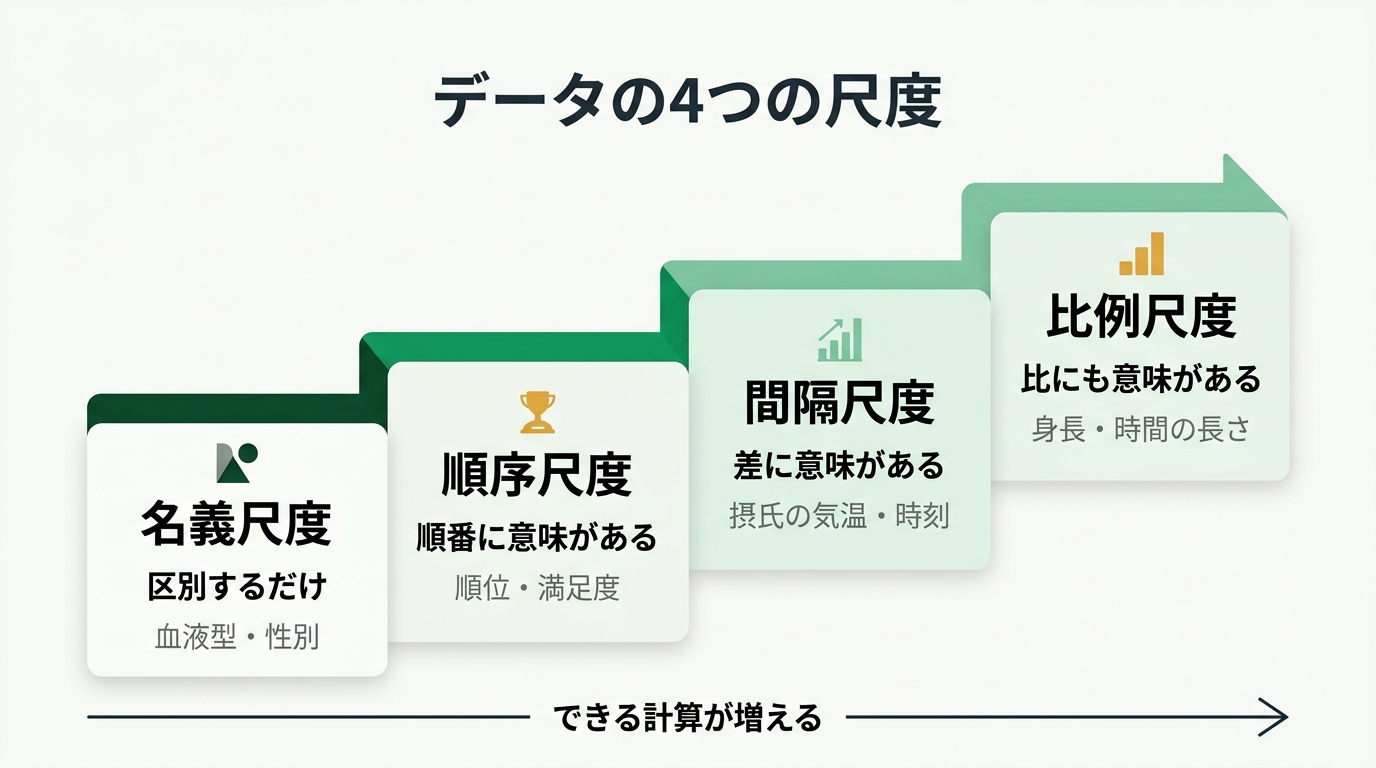
右の尺度ほど、意味のある計算が増えます。
4つの尺度
名義尺度 … 区別するためだけの値。血液型、性別、背番号など。大小も順番もない
順序尺度 … 順番には意味があるが、間の幅はそろっていない。順位、満足度の5段階、学年など
間隔尺度 … 目盛りの幅がそろっていて差に意味があるが、0 が「何もない」を表さない。摂氏の気温、時刻、西暦など
比例尺度 … 0 が「何もない」を表し、比(何倍か)にも意味がある。身長、重さ、金額、睡眠時間などの時間の長さ
間隔尺度と比例尺度の分かれ目は「2倍と言えるか」です。20℃ は 10℃ の2倍暑いとは言えず、午後2時は午前7時の2倍ではありません。8時間の睡眠は4時間の2倍で、0時間は「眠っていない」を表します。時刻(ある時点)は間隔尺度、時間の長さは比例尺度です。
確率・順列・組合せ
どれも同じ確からしさで起きるとき、確率は「その事がらの起き方の数÷全部の起き方の数」です。互いに影響しない事がらが続けて起きる確率は、それぞれを掛け合わせます。サイコロを2回投げて6が1回も出ない確率を求めます。
1回投げて6が出ない確率=6以外の目の数÷全部の目の数
  5 ÷ 6 = 5/6
2回とも6が出ない確率=1回目の確率×2回目の確率
  5/6 × 5/6 = 25/36
(数えて確かめる:全部 6×6=36通り、どちらも6以外 5×5=25通り)
「少なくとも1回は出る」確率は、1から「1回も出ない」確率を引いて求めます。 ここでは 1-25/36=11/36 です。投げる回数が増えても、1回分の確率を回数だけ掛けるやり方は同じです。
5人から委員長と副委員長を選ぶように順番を区別するのが順列、役割のない代表2人のように区別しないのが組合せです。
順列=1人目の選び方×2人目の選び方
  5 × 4 = 20通り
組合せ=順列÷選んだ2人の並べ方
  20 ÷(2×1)= 10通り
当たりの確率が 1/4 のくじを2回引きます(引いたくじは毎回もとに戻します)。少なくとも1回当たる確率はどれですか。
○ 正解 7/16です。
1回で外れる確率は 1-1/4=3/4。2回とも外れる確率は 3/4×3/4=9/16。少なくとも1回当たる確率は 1-9/16=7/16 です。
× 1/4+1/4 と足すと「2回とも当たり」を二重に数えます。「1回も当たらない」を1から引きます。
× 2回とも外れる確率です。求めるのはその反対なので、1から引く必要があります。
× 1/4×1/4 で、2回とも当たる確率です。1回だけ当たる場合が入っていません。
確率・順列と組合せ・代表値・偏差値の計算だけをまとめ、数字を入れると途中の式まで出る計算機を置いたページもあります ── 確率と代表値の計算。
相関・回帰と、調査のゆがみ
2つの量の関係の強さを相関係数(-1 から 1)で調べるのが相関分析です。相関があっても因果とは限りません。アイスの売上と水難事故がそろって増えるのは、どちらも気温という別の要因で動くからで、この見かけの関係を擬似相関といいます。
回帰分析は、一方の値(説明変数)からもう一方(目的変数)を推定する式を求める方法です。一次式なら y=ax+b の直線です。
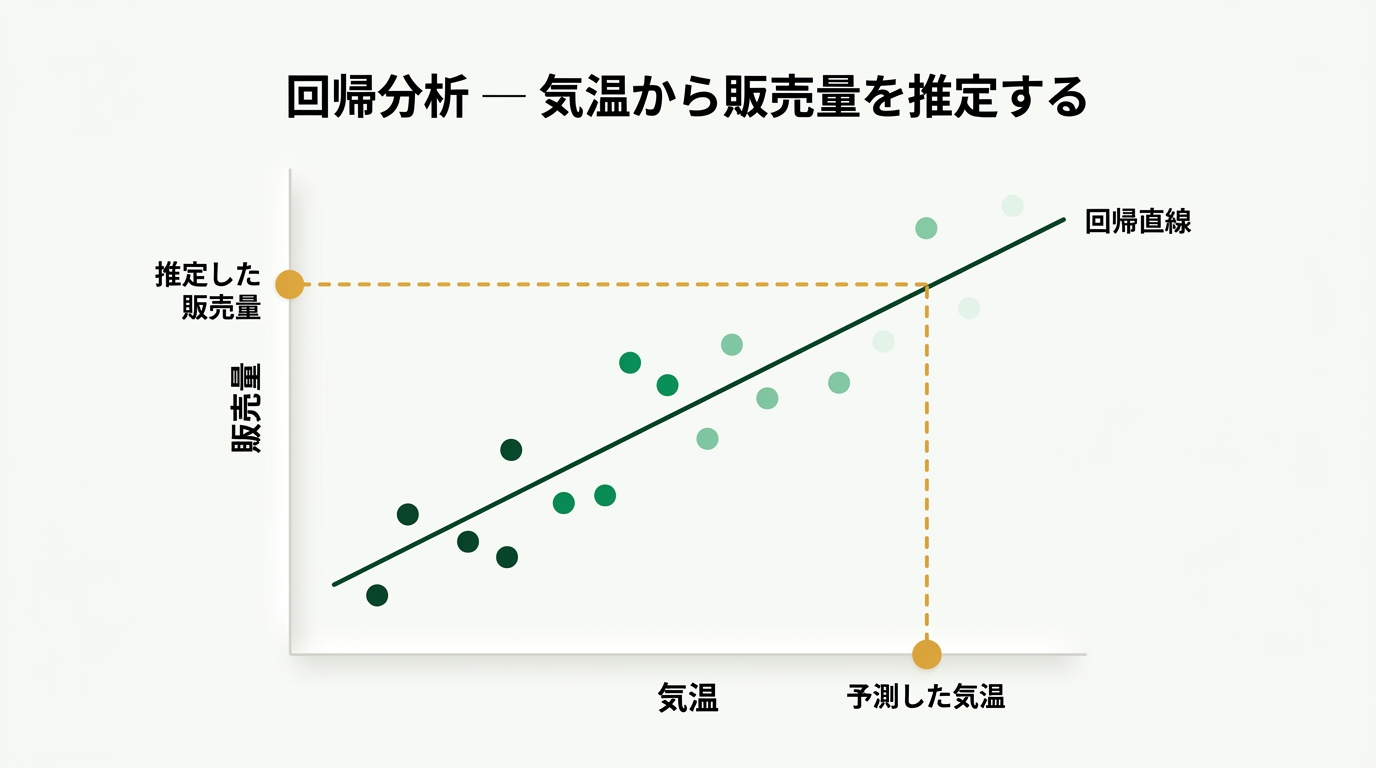
点の並びに直線を当てはめておけば、気温を決めると販売量が読み取れます。
過去の記録から「販売量=20×気温-100」が得られたとして、気温30℃の日を推定します。
販売量=20×気温-100
  20 × 30 - 100 = 600 - 100 = 500個
一方の値から、もう一方の値を式で推定するのが回帰分析です。線形計画法は制約の中で利益が最大になる生産量などを求める方法、 デルファイ法は専門家への匿名のアンケートをくり返して意見をまとめ、将来を予測する方法、 パレート分析は項目を多い順に並べて累積の割合を見て、重点的に取り組む項目を絞る方法です(線形計画法とパレート分析は 9-3 業務分析)。
対象の全員を調べるのが全数調査(国勢調査など)、一部を標本として抜き出して全体を推し量るのがアンケート調査などの標本調査です。 だれもが同じ確率で選ばれるよう、くじ引きのように選ぶのが単純無作為抽出です。 Webアンケートだけでスマホの利用率を調べるとネットを使う人に偏るように、集め方のせいで結果が実態からずれるのが統計的バイアス、 自分の考えに合う情報ばかり集めるような人の判断の偏りが認知バイアスです。データの差が偶然の範囲かどうかを確率で判断するのが仮説検定です。
結果を見せるグラフは、量を比べる棒グラフ、時間による変化を見る折れ線グラフ、表のマスを色の濃さで塗るヒートマップ、複数の項目のバランスを見るレーダーチャートを使い分けます。
データを集めて整え、分析して業務の打ち手につなげるまでを担うのがデータサイエンティストです。通販会社なら、「どの会員が来月解約しそうか」を問いにして購入や問い合わせの記録を分析し、解約しそうな会員を見込む仕組みを作って、販促の担当者と手の打ち方を決めます。IPA のデジタルスキル標準では、DX を進める人材の類型の1つです。
まとめ
この回で持ち帰ること
1. 1次データは自分で集めたもの、2次データは他者が集めたもの。表の形なら構造化、文章や画像は非構造化。ビッグデータは量・速さ・種類の3つ(3V)
2. 名寄せ=同じ人のデータを手掛かりで1つにまとめる。アノテーション=データに正解のラベルを付ける。季節調整・移動平均で動きを見やすくする
3. 平均値=合計÷個数、中央値=並べた真ん中、最頻値=いちばん多い値。平均値は飛び抜けた値に引っ張られる。ばらつきは標準偏差で表し、偏差値=50+10×(得点-平均点)÷標準偏差
4. 尺度は名義・順序・間隔・比例。時刻や摂氏の気温は差だけに意味がある間隔尺度、時間の長さは比例尺度
5. 続けて起きる確率は掛ける。「少なくとも1回」は 1-「1回も起きない」
6. 回帰分析は一方の値からもう一方を式で推定する。相関は因果とは限らない(擬似相関)。集め方の偏りが統計的バイアス
この節で解ける公開問題
令和4〜8年度の公開問題のうち、この節の知識で解ける問題は次の8問です。
教科書の一覧(現行の試験の順)教科書の一覧(新しい試験の順)過去問


Udemy の ITパスポート講座を、受講者数・★評価・口コミで比べたページです(広告を含みます)。
出典:IPA「ITパスポート試験 シラバス(案)Ver0.1」(2026年8月31日)、「ITパスポート試験 シラバス Ver6.5」、 総務省・経済産業省「AI事業者ガイドライン(第1.2版)」、デジタル庁「オープンデータ基本指針」(令和6年7月5日改正)、IPA「デジタルスキル標準(DX推進スキル標準)」。 練習問題と計算例の数値は、当サイトが説明のために作ったものです。