業務を支えるシステムは、部品がいつか壊れることを前提に、壊れても止まらない・止まってもすぐ戻るように組み立てます。
RASIS:システムを評価する5つの観点
システムの良し悪しを測る観点を、英語の頭文字をつなげて RASIS(レイシス)と呼びます。
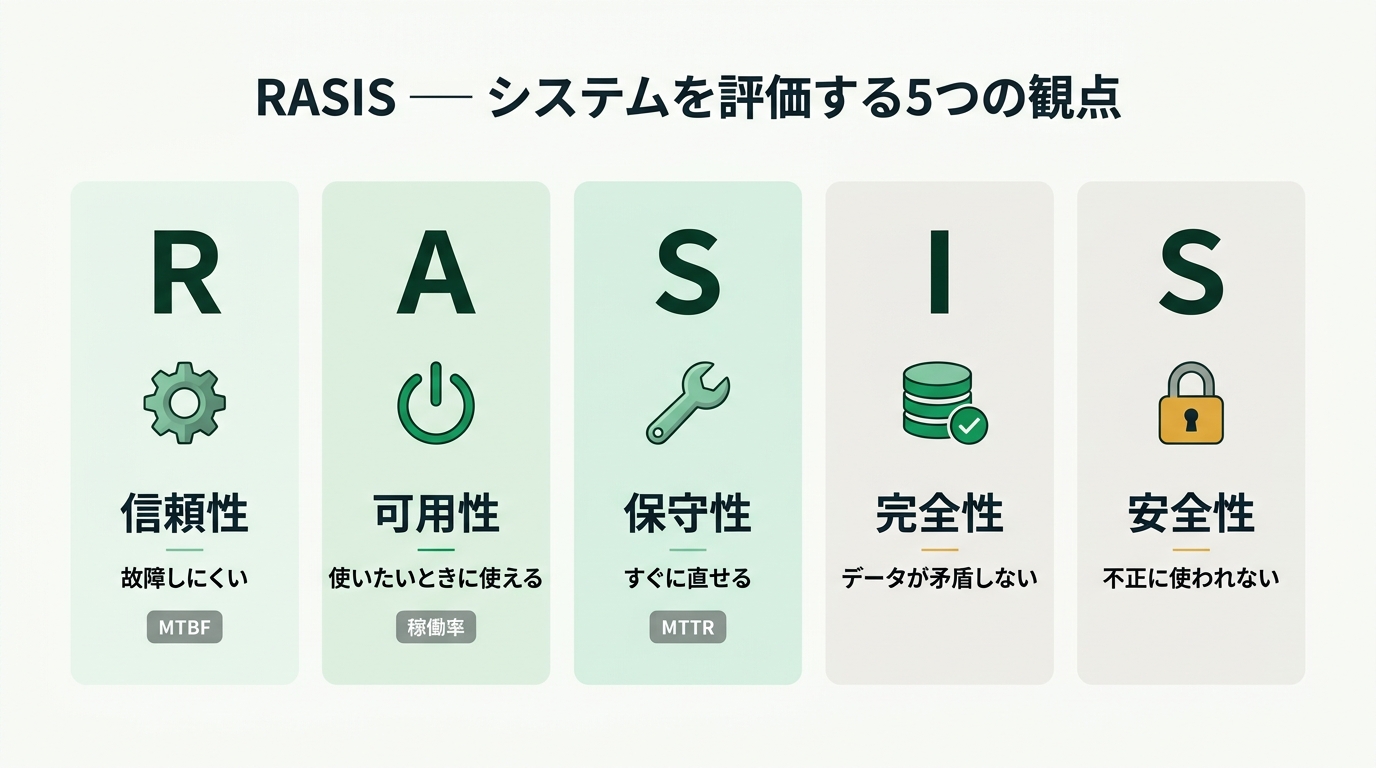
頭文字をつなげて RASIS。最初の3つには、数字で測る指標があります。
R 信頼性(Reliability) … 故障しにくいこと。指標は MTBF(長いほどよい)
A 可用性(Availability) … 使いたいときに使えること。指標は稼働率(1に近いほどよい)
S 保守性(Serviceability) … 故障してもすぐに直せること。指標は MTTR(短いほどよい)
I 完全性(Integrity) … データが壊れたり矛盾したりしないこと
S 安全性(Security) … 不正に使われたり、情報を盗まれたりしないこと
この5つは「止まらずに正しく動くか」を見る観点です。これとは別に、経済性は導入から運用までにかかる費用の総額(TCO)で、性能はレスポンスタイム(要求してから応答が返るまでの時間)などで測ります。 新しいサーバの候補2機種の性能を比べるときは、両方に同じ評価用のプログラムを走らせ、終わるまでの時間を測ります。この比べ方をベンチマークといい、同じ処理を同じ条件で実際に動かすので、機種どうしを公平に比べられます。
信頼性設計:冗長化とRAID
壊れても止めないための基本の手は、同じ役割の部品を余分に持っておくことです。これを冗長化といいます。 コンピュータを2系統持つ形には、2系統で同じ処理を同時に行い結果を照らし合わせるデュアルシステムと、 ふだんは主系だけが動き、故障したら待機系に切り替えるデュプレックスシステムがあります。 待機系をすぐ動ける状態で待たせるのがホットスタンバイ、電源を切るなどして待たせ、切替に時間がかかるのがコールドスタンバイです。
信頼性設計の3つの考え方
フォールトトレラント … 一部が故障しても、システム全体は動き続けるようにする
フェールセーフ … 故障したときは安全な側に止める。例:信号機が故障したら赤を点灯する
フールプルーフ … 人がまちがった操作をしても事故にならないようにする。例:ふたを閉めないと動かない洗濯機
データを置くハードディスク(HDD)を冗長化する代表が RAID(レイド)です。複数のディスクを束ねて、1台の大きなディスクのように使います。 束ね方には番号が付いていて、公開問題に出てくるのは次の3つです。
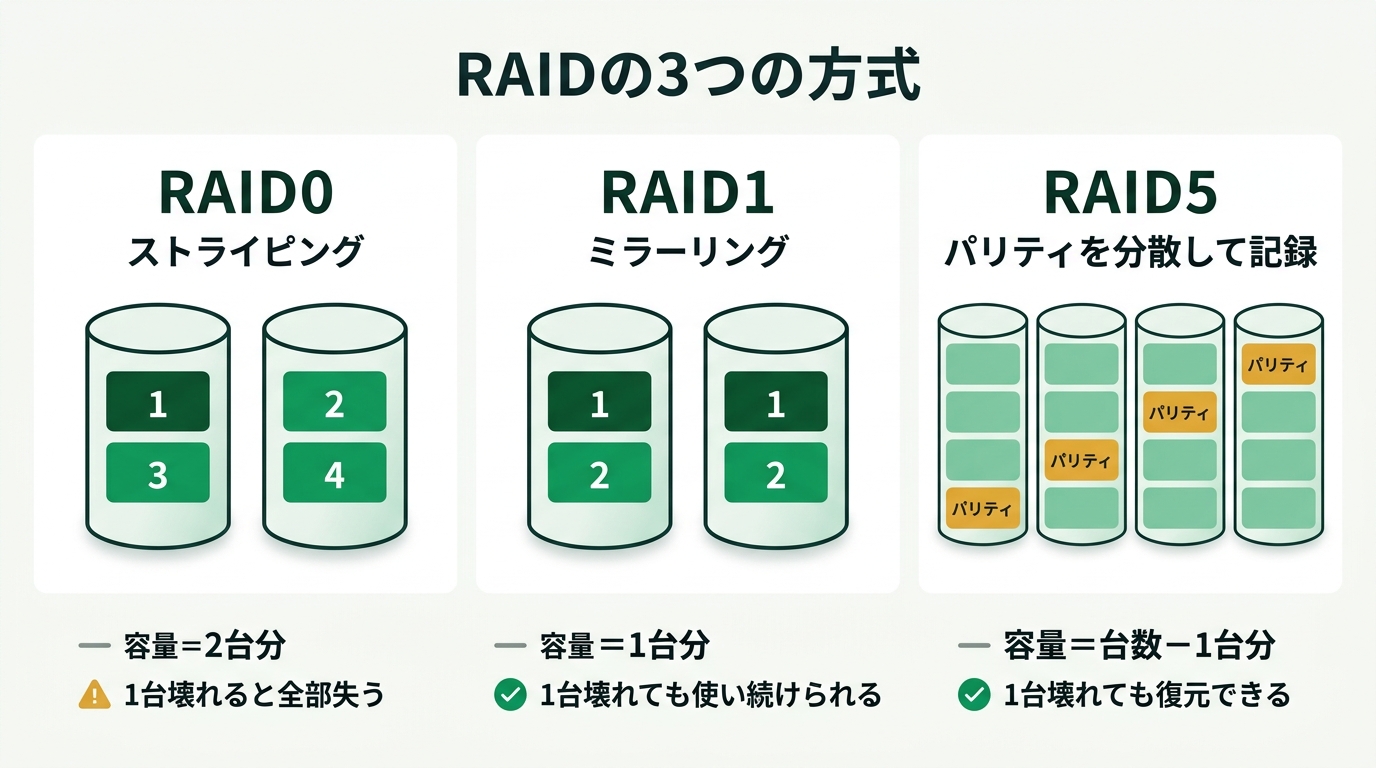
分けて書くのがストライピング、同じものを書くのがミラーリング。RAID5 は1台分をパリティに使います。
RAID0(ストライピング) … データを分けて、複数のディスクにばらばらに書く。読み書きは速く、容量は全台分。ただし冗長性が無く、1台壊れるとデータ全体を失う
RAID1(ミラーリング) … 2台に同じデータを書く。1台壊れても、もう1台で使い続けられる。容量は1台分
RAID5 … データを分けて書くのに加え、壊れた1台の中身を計算で作り直すためのパリティを、全ディスクに分散して書く。最低3台。1台壊れても復元できる(同時に2台壊れると復元できない)
RAID の容量は「何台分を、データ以外のことに使うか」で決まります。 RAID0 は全台がデータ、RAID1 は2台で同じものを書くので半分、RAID5 は1台分をパリティに使います。
3TBのディスク2台
  RAID0:3 × 2 = 6TB
  RAID1:3 × 1 = 3TB
2TBのディスク5台でRAID5
  容量 =(台数 - 1)× 1台の容量
  (5 - 1)× 2 = 8TB
容量は GB(ギガバイト)で書かれることもあります。1TB(テラバイト)= 1000GB です。
RAID はディスクの故障に備えるもので、バックアップの代わりにはなりません。 人がまちがえてファイルを消すと、ミラーリングでも両方のディスクから消えます。
社内のファイルサーバに、容量2TBのHDDを6台入れて RAID5 を組みました。データを保存できる容量はおよそいくらですか。
× 6台すべてをデータに使う計算で、RAID0(ストライピング)の容量です。RAID5 は1台分をパリティに使います。
× 半分を引いています。半分になるのは、同じデータを2台に書くミラーリングの考え方です。
○ 正解 10TBです。
RAID5 は1台分の容量をパリティに使うので、データに使えるのは(6 - 1)× 2 = 10TB です。
× 1台分しか数えていません。RAID5 で減るのは1台分だけです。
RAID を組んだディスクは、ネットワークに直接つなぐ箱としても使われます。家庭や小さな事務所なら、ハードディスクを収めた箱を LAN のルーターにつなぐだけで、家族や社員のパソコンやスマホから写真や書類を出し入れできる置き場になります。このように、サーバを用意しなくても、それ自体がネットワークの一員として働く記憶装置を NAS(Network Attached Storage)といいます。
稼働率と、MTBF・MTTR
稼働率は、システムが使える状態にある時間の割合です。SLA で「稼働率99.9%」のように約束し、そこから止めてよい時間を出す計算は、サービスマネジメントの回で扱っています。 この回では、故障と修理の繰り返しから稼働率を出す方法と、装置を組み合わせたときの稼働率を見ます。
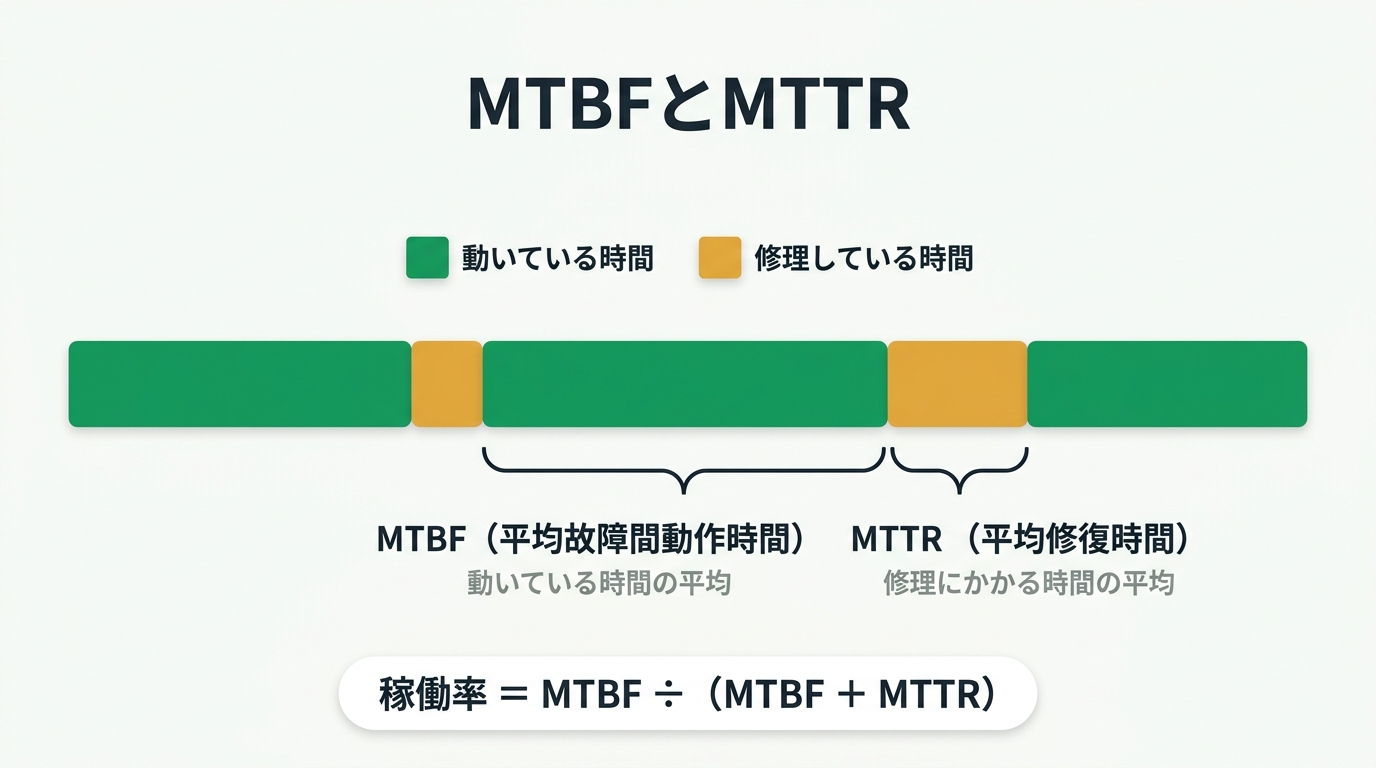
動いている時間と修理している時間を足したうち、動いている時間の割合が稼働率です。
システムは「動く → 故障する → 修理する → また動く」を繰り返します。動いている時間の平均が MTBF(平均故障間動作時間)、修理にかかる時間の平均が MTTR(平均修復時間)です。 MTBF が長いほど故障しにくく(信頼性)、MTTR が短いほどすぐ直る(保守性)システムです。
稼働率 = MTBF ÷(MTBF + MTTR)
  MTBF 190時間、MTTR 10時間のとき
  190 ÷(190 + 10)= 190 ÷ 200 = 0.95
稼働率を上げる手は2つあります。故障しにくくして MTBF を延ばすか、早く直して MTTR を縮めるかです。 上の例で MTTR を5時間に縮めると、190 ÷ 195 ≒ 0.974 に上がります。 また、1から稼働率を引いた値(ここでは 1 - 0.95 = 0.05)は、止まっている確率です。次の並列の計算で使います。
直列と並列の稼働率
システムは複数の装置でできています。装置どうしのつなぎ方は2通りで、稼働率の計算のしかたが違います。 どちらも、装置は互いに無関係に故障するものとして計算します。
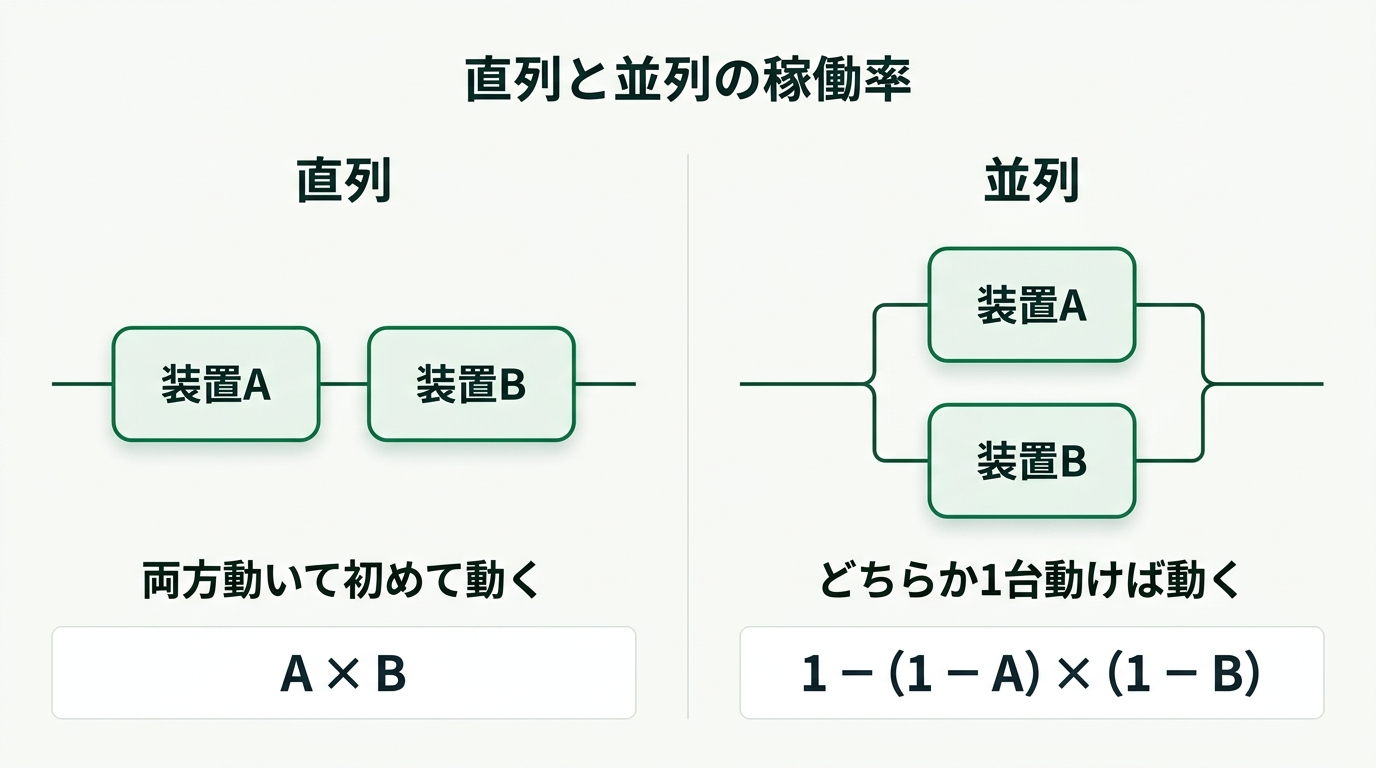
直列は掛け算、並列は「両方止まる確率」を1から引きます。
直列は、全部の装置が動いて初めてシステムが動くつなぎ方です(例:Webサーバとデータベースサーバ。どちらが止まってもサービスは止まる)。 稼働率は掛け算で、つなぐほど下がります。
直列の稼働率 = A × B
  A = 0.95、B = 0.98 のとき
  0.95 × 0.98 = 0.931
並列は、どれか1台でも動いていればシステムが動くつなぎ方です。 システムが止まるのは全部の装置が同時に止まったときだけなので、まず「全部止まる確率」を出し、1から引きます。
並列の稼働率 = 1 -(1 - A)×(1 - B)
  A = B = 0.7 のとき
  1台が止まっている確率:1 - 0.7 = 0.3
  2台とも止まっている確率:0.3 × 0.3 = 0.09
  1 - 0.09 = 0.91
並列は「全部が止まる確率」を出してから、1から引きます。 0.7 の装置でも、2台並べると 0.91 まで上がります。
並列と直列が混ざっていたら、並列の部分を先に1つの装置にまとめ、それから直列として掛けます。 0.7 のサーバ2台の並列に、0.9 のサーバ1台が直列につながっているなら、並列の部分が 0.91 になり、0.91 × 0.9 = 0.819 ≒ 0.82 です。
目標の稼働率に届くまで何台並べればよいかは、1台ずつ増やして確かめます。 稼働率 0.6 の装置で、システムの稼働率を 0.95 以上にしたい場合、止まっている確率は1台あたり 0.4 です。
全部止まる確率 = 0.4 を台数の回数だけ掛けたもの
  2台:1 - 0.4 × 0.4 = 1 - 0.16 = 0.84
  3台:1 - 0.16 × 0.4 = 1 - 0.064 = 0.936
  4台:1 - 0.064 × 0.4 = 1 - 0.0256 = 0.9744
3台では 0.95 に届かず、4台で初めて超えるので、最低4台です。 計算した稼働率が目標の値とちょうど同じになった台数でも、目標に届いたことになります。
ある店舗の注文システムは、稼働率 0.6 の通信回線を2本引いていて、どちらか一方が使えれば本部と通信できます。 その先にある稼働率 0.95 の注文サーバ1台も動いていれば、注文を受けられます。注文を受けられる確率(システム全体の稼働率)は、小数第3位を四捨五入するといくらですか。
× 3つすべてを直列として 0.6 × 0.6 × 0.95 を計算しています。回線は並列なので、どちらか1本が使えれば足ります。
× 回線の並列の部分(0.84)だけで止めています。直列につながる注文サーバの 0.95 を掛け忘れています。
× 注文サーバまで並列として、1 - 0.4 × 0.4 × 0.05 を計算しています。注文サーバは1台だけで、止まれば注文を受けられない直列です。
○ 正解 0.80です。
並列の部分は 1 -(1 - 0.6)×(1 - 0.6)= 1 - 0.16 = 0.84。これに注文サーバを直列で掛けて 0.84 × 0.95 = 0.798 ≒ 0.80 です。
稼働率の計算だけを5つの形でまとめ、数字を入れると途中の式まで出る計算機を置いたページもあります ── 稼働率の計算。
スケールアップとスケールアウト
利用者が増えて処理が追いつかなくなったとき、処理能力を上げる方法は2つあります。
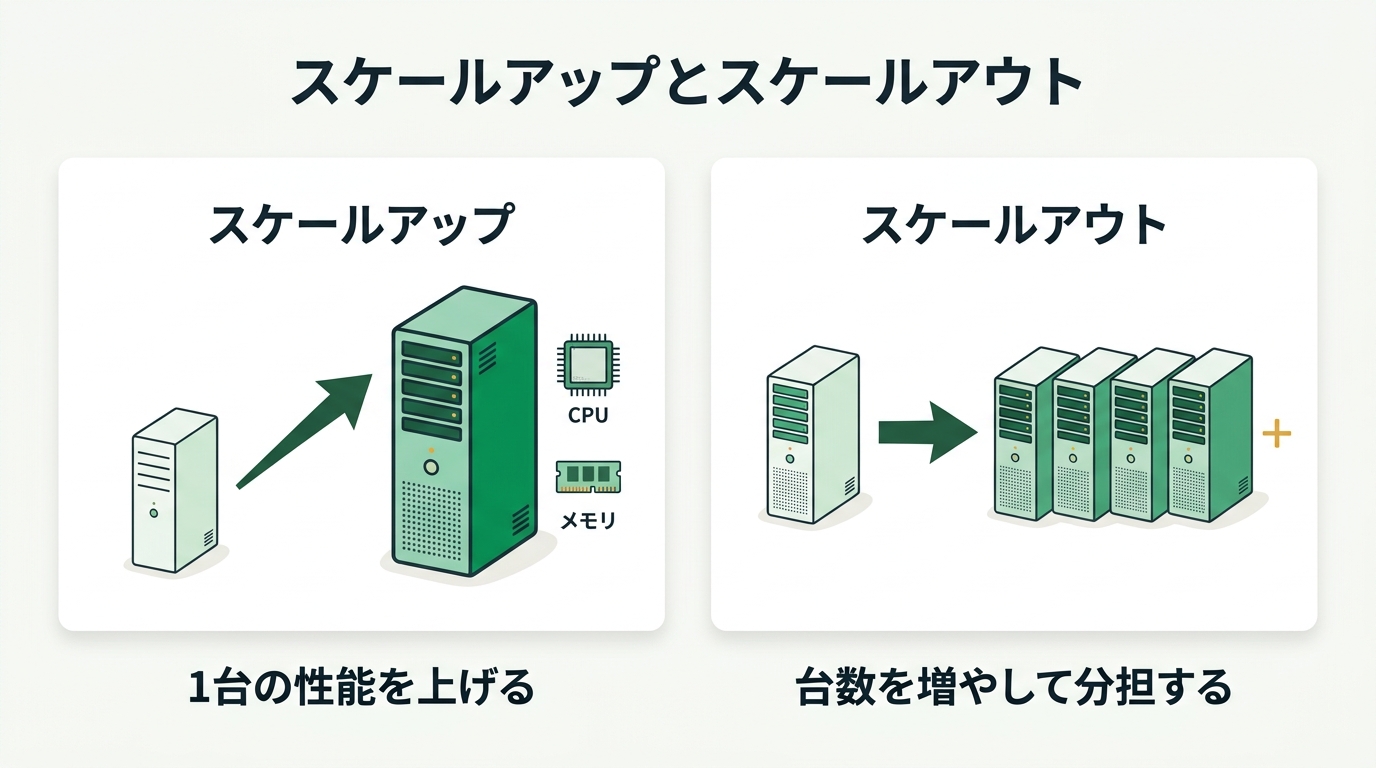
1台を強くするのがスケールアップ、台数を増やすのがスケールアウトです。
スケールアップ … サーバ1台の性能を上げる。CPU やメモリを強化する、より高性能な機種に替える。構成は変わらないが、1台で伸ばせる性能には上限がある
スケールアウト … サーバの台数を増やして処理を分担する。多数の利用者からの、互いに無関係な要求をさばく Webサーバなどに向く。1台が止まっても残りが動き続ける
スケールアウトは、処理を複数のコンピュータに分けて行う分散処理の考え方です。1台のコンピュータにすべてを集める形は集中処理といいます。 分散処理の代表が、サービスを提供するサーバと、それを利用するクライアント(利用者のPCなど)で役割を分けるクライアントサーバシステムです。
台数を増やすと、どのサーバでも同じデータを使えるようにする必要が出てきます。通販サイトで、在庫を記録したデータベースを東京と大阪の2台に置き、東京で在庫が減ったらその変更を大阪にも書き写して、2台の中身をいつも同じに保ちます。この仕組みをレプリケーションといい、片方が止まってももう片方で同じデータが使え、読み出しの処理を2台に分けることもできます。
1台の物理的なコンピュータを複数のコンピュータのように使う仮想化や、複数のサーバを1つのシステムとして動かすクラスタは、クラウドの基盤技術として別の回で扱います。
まとめ
この回で持ち帰ること
1. RASIS=信頼性(MTBF)・可用性(稼働率)・保守性(MTTR)・完全性・安全性
2. 冗長化=余分に持って壊れても止めない。フォールトトレラント=動き続ける、フェールセーフ=安全側に止める、フールプルーフ=誤操作でも事故にしない
3. RAID0=ストライピング(全台分・冗長性なし)、RAID1=ミラーリング(1台分)、RAID5=パリティを分散(台数-1台分・1台の故障まで復元)
4. 稼働率=MTBF÷(MTBF+MTTR)。MTBF を延ばすか MTTR を縮めると上がる
5. 直列=掛け算。並列=1-(全部止まる確率)。混ざっていたら並列の部分を先にまとめる。必要な台数は1台ずつ増やして確かめる
6. スケールアップ=1台を強くする。スケールアウト=台数を増やして分担する
この節で解ける公開問題
令和4〜8年度の公開問題のうち、この節の知識で解ける問題は次の5問です。
信頼性設計
教科書の一覧(現行の試験の順)教科書の一覧(新しい試験の順)過去問


Udemy の ITパスポート講座を、受講者数・★評価・口コミで比べたページです(広告を含みます)。
出典:IPA「ITパスポート試験 シラバス(案)Ver0.1」(2026年8月31日)、「ITパスポート試験 シラバス Ver6.5」。 練習問題と計算例は当サイトが説明のために作ったものです。